


SkillNet 技术报告总结
15 万+ 技能、4 种关系、5 维评估——面向 AI Agent 的大规模技能图谱
SkillNet 全面研究总结:面向 AI Agent 的大规模技能图谱基础设施
论文标题: SkillNet: Create, Evaluate, and Connect AI Skills
arXiv: 2603.04448 · cs.AI / cs.CL / cs.CV / cs.LG / cs.MA
作者: Yuan Liang, Ruobin Zhong, Haoming Xu, Chen Jiang 等共 49 位 (浙江大学 ZJUNLP、同济大学、东南大学、阿里巴巴、蚂蚁集团、腾讯、OPPO 等多机构联合)
通讯作者: Ningyu Zhang (zhangningyu@zju.edu.cn)
发布时间: 2026 年 2 月(OpenKG 新春首发)
资源: 网站 | GitHub (⭐144) | Python SDK | API
目录
- 一、研究动机与核心问题
- 二、SkillNet 概览
- 三、什么是 Agent Skill?
- 四、SkillNet 端到端流水线
- 五、Skill Ontology(技能本体)
- 六、开放资源与工具
- 七、实验评估
- 八、应用场景
- 九、与现有平台的对比
- 十、Related Work 核心对比
- 十一、未来方向
- 十二、局限性
- 十三、核心总结
- 十四、结合 SkillNet 做 LLM 数据合成研究的思路方向
一、研究动机与核心问题
当前 AI Agent 虽然能灵活调用工具、执行复杂任务,但缺乏系统性的技能积累与迁移机制。Agent 在孤立场景中反复”重新造轮子”,无法将过往的成功策略沉淀并复用。
论文引用 Richard S. Sutton 的观点点明时代背景:
“We are in the era of experience.” Intelligence is increasingly grounded not in ab initio knowledge acquisition, but in the efficient retrieval and adaptive reuse of heuristics distilled from prior experience.
作者进一步从知识工程的历史演进角度阐述了这一问题:
| 时代 | 特点 | 局限 |
|---|---|---|
| 符号时代 (Symbolic Era) | 依赖刚性符号逻辑,可解释性强 | 脆弱、可扩展性差 |
| 深度学习时代 (Deep Learning Era) | 知识参数化为高维权重矩阵 | 表示不透明,难以模块化复用 |
| Agent 时代 (Agentic Era,当前前沿) | 向 Agent 技能 (Skills) 收敛 | 缺乏统一的技能组织和评估框架 |
核心挑战在于:如何将 Agent 的碎片化经验转化为持久、可迁移的掌控能力?
二、SkillNet 概览
SkillNet 是一个开放基础设施,旨在大规模地创建、评估和组织 AI 技能。
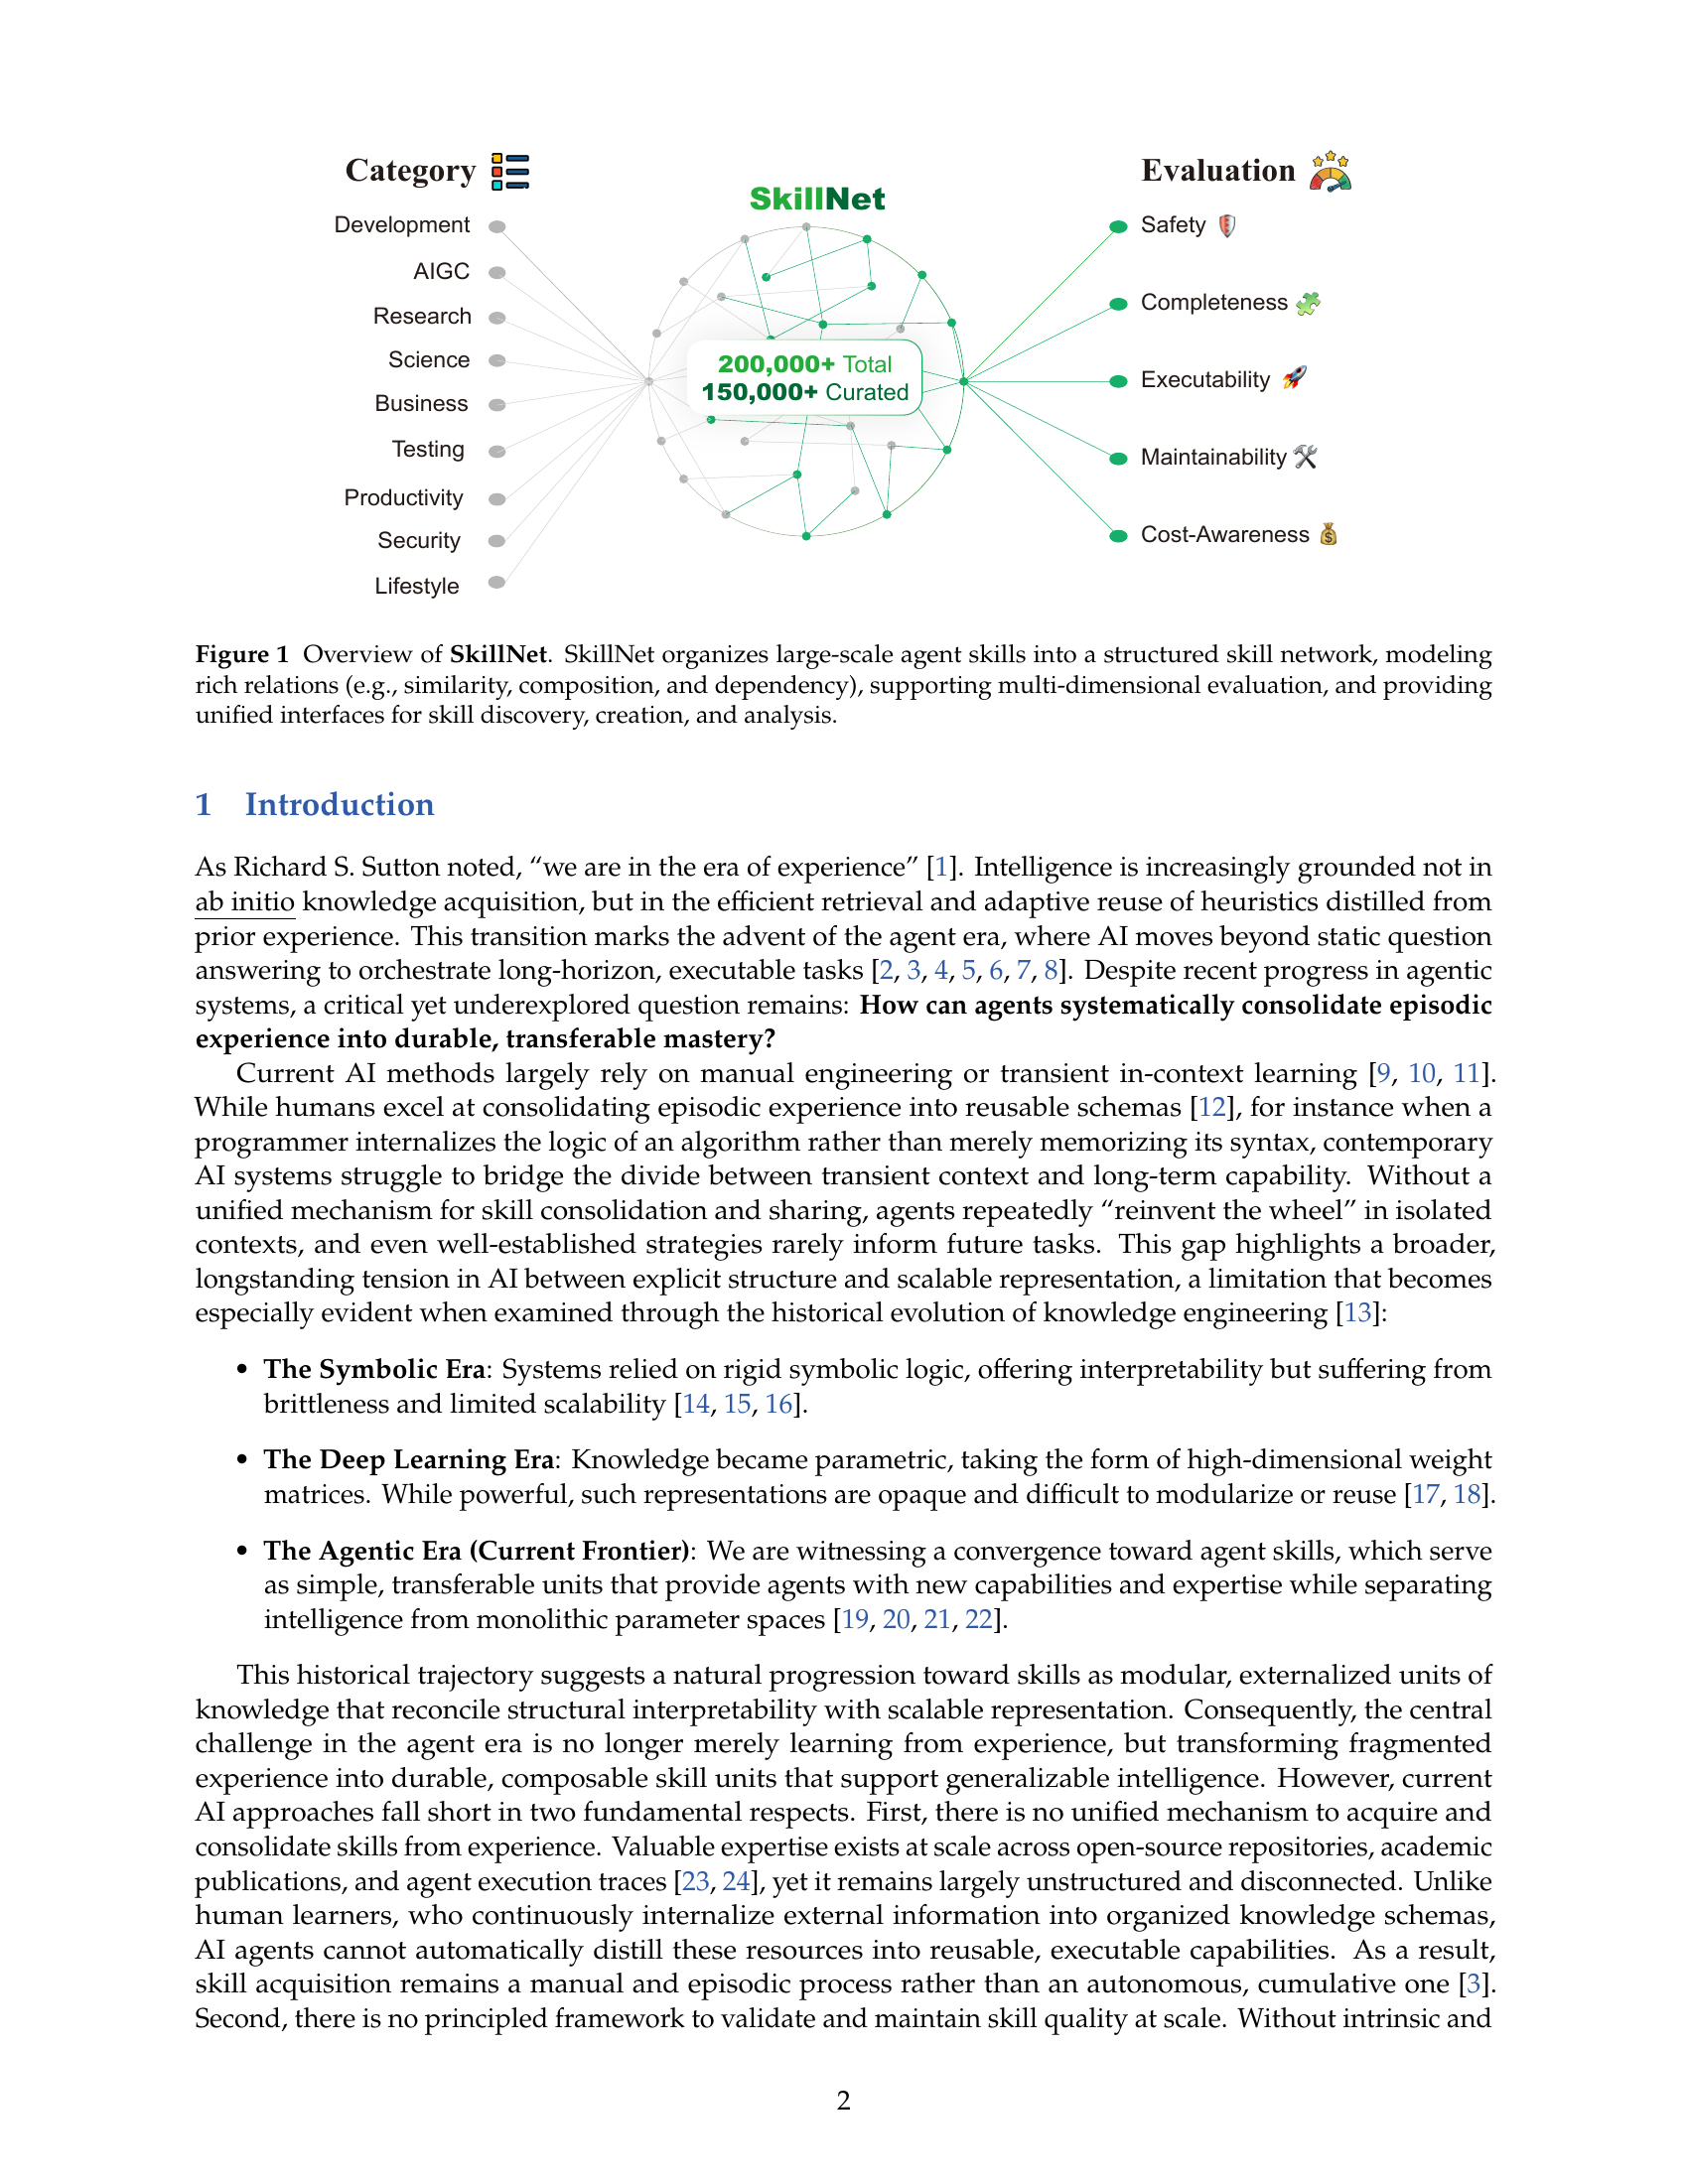
Figure 1: SkillNet 将大规模 Agent 技能组织为结构化技能网络,建模丰富的关系(如相似性、组合、依赖),支持多维度评估,并提供统一的技能发现、创建和分析接口。
核心数据规模
- 200,000+ 总技能
- 150,000+ 经过筛选的高质量技能
- 覆盖 10 大类别: Development, AIGC, Research, Science, Business, Testing, Productivity, Security, Lifestyle 等
三、什么是 Agent Skill?
在 Agent 系统中,Skill(技能) 是一种轻量级、模块化、可复用的抽象,用于扩展 AI Agent 的能力:
A skill serves as a unified knowledge representation that integrates entities, relationships, workflows, and executable code, encompassing both textual semantics and symbolic outcomes.
Skill 的组织形式
- 以结构化文件夹组织,包含核心
SKILL.md文件 - 元数据定义技能名称、用途、使用条件
- 可选包含脚本、模板、文档等执行资源
Skill 的三步渐进式使用流程
- Discovery(发现): Agent 加载最少量元数据,识别与任务相关的技能
- Activation(激活): 匹配后读取完整指令,准备关联资源
- Execution(执行): Agent 按指令操作,可选地执行捆绑代码或引用资源
四、SkillNet 端到端流水线
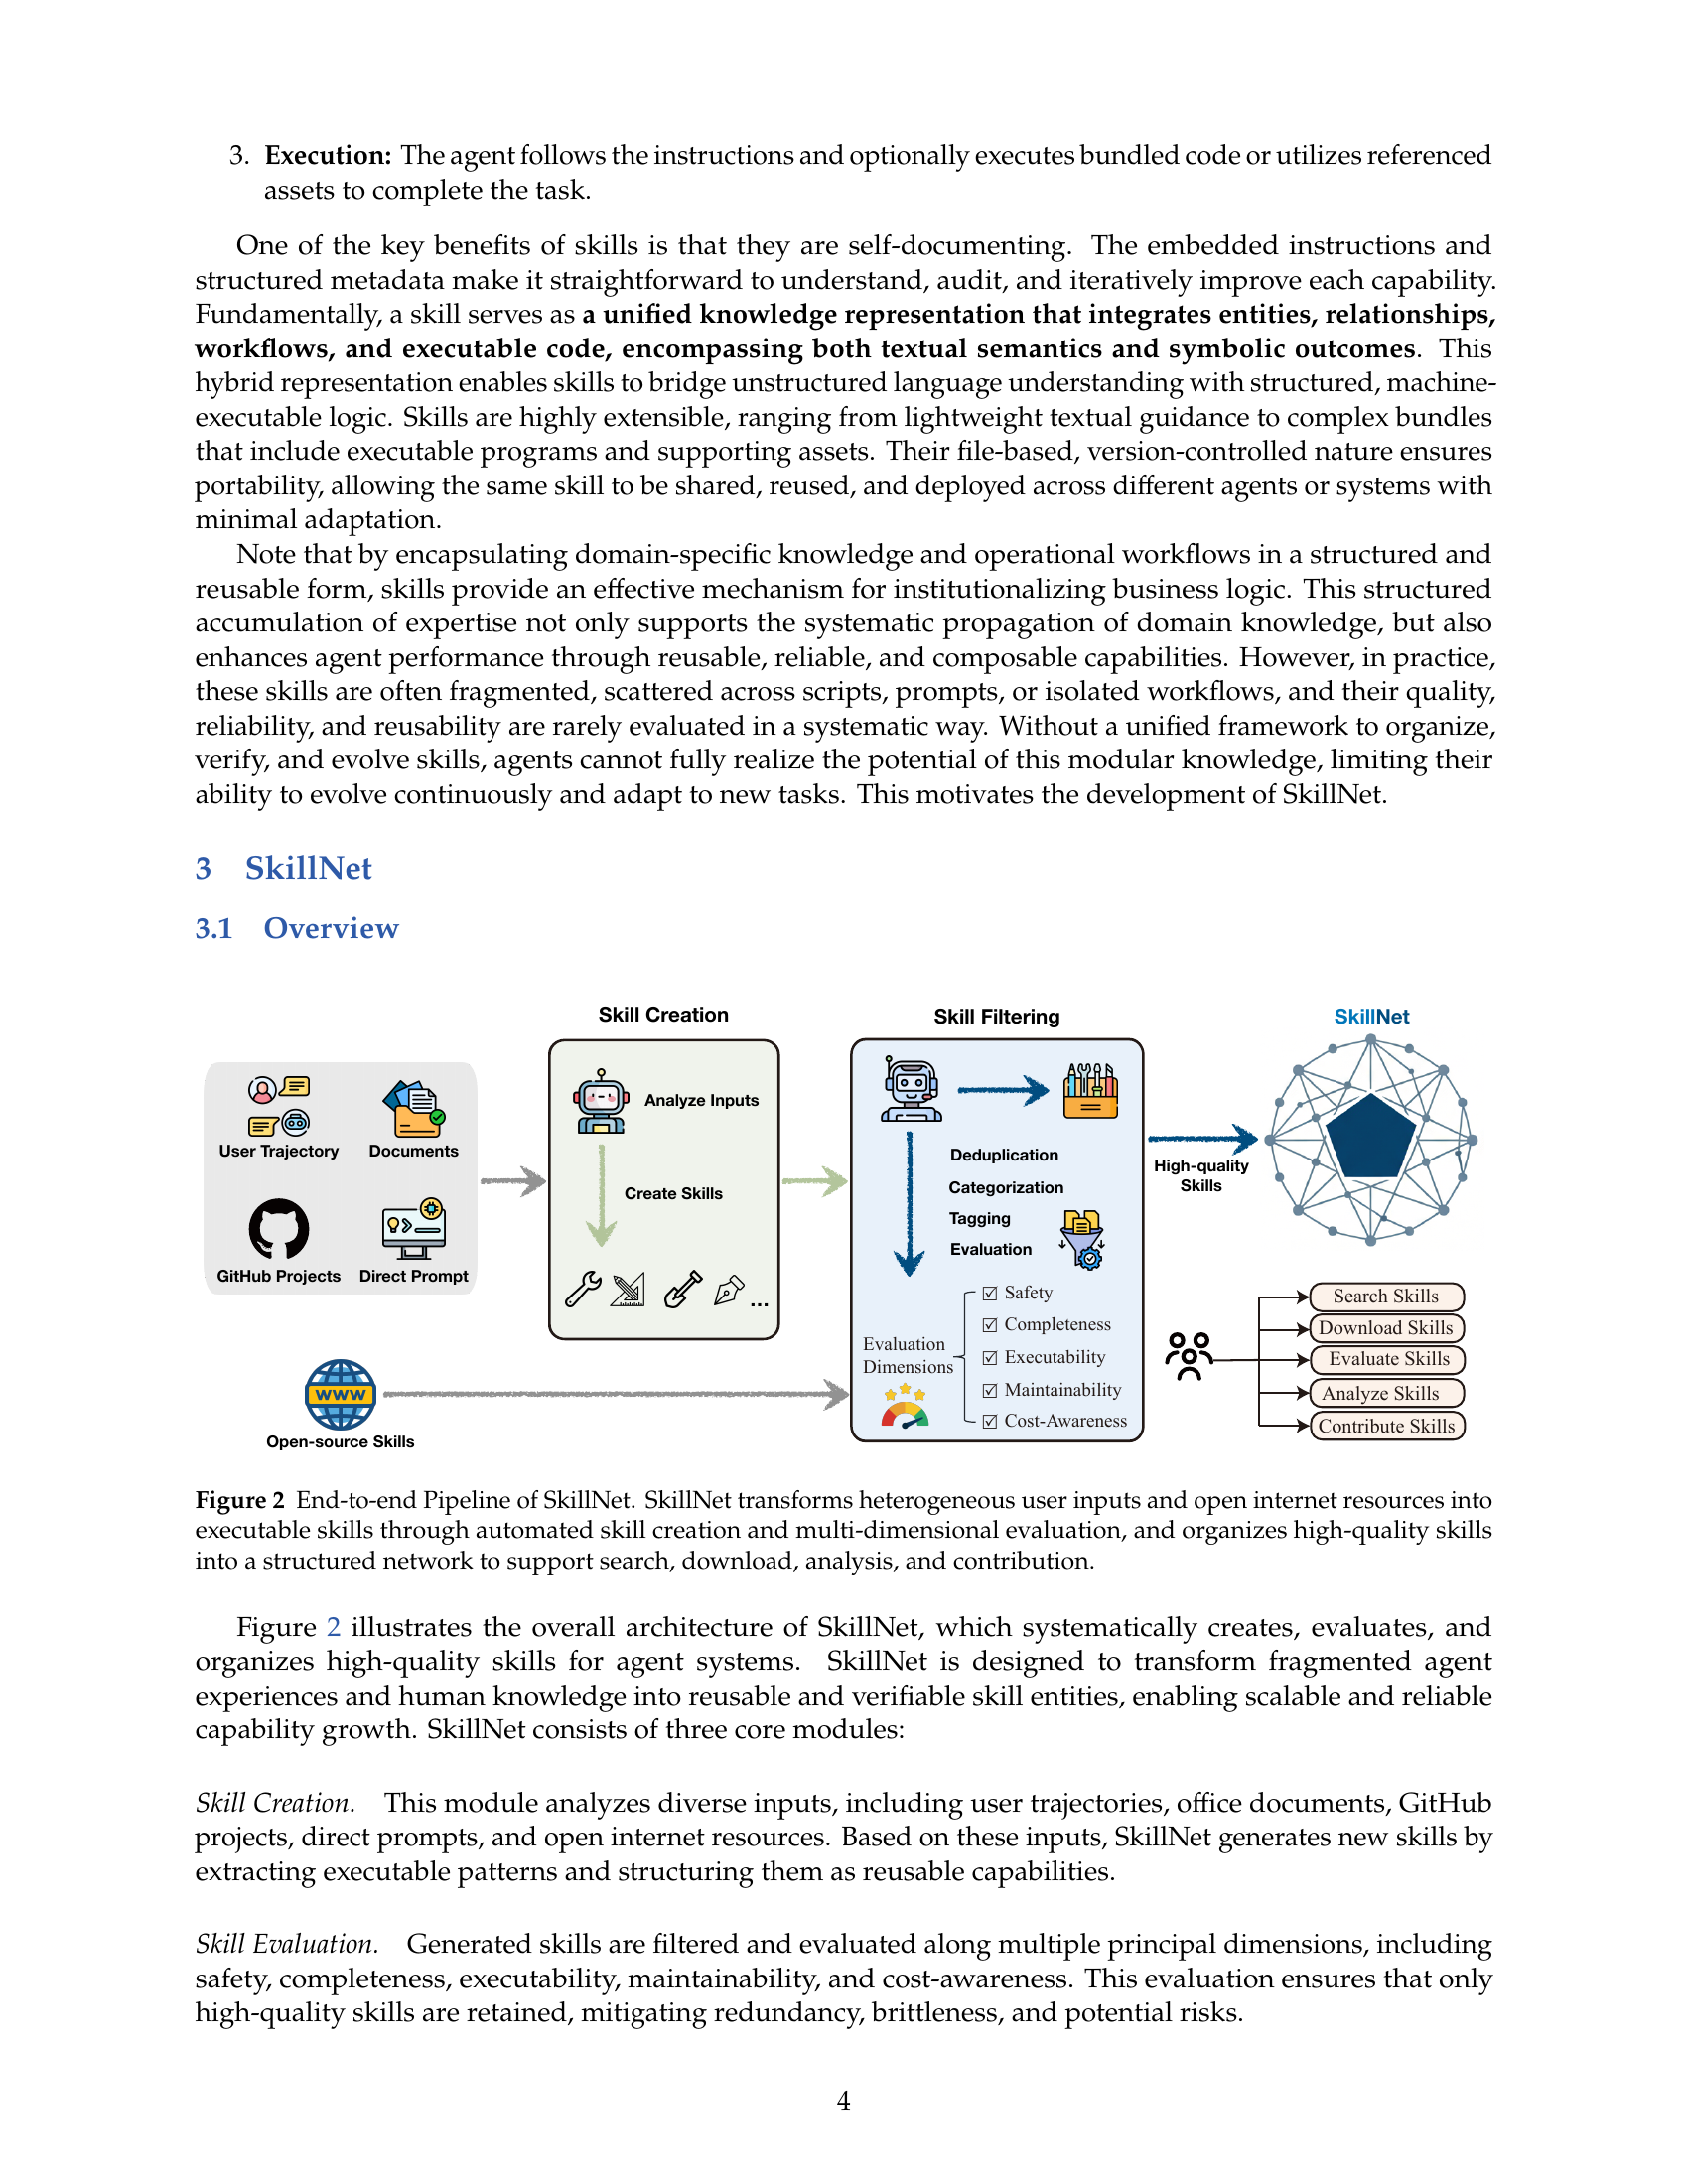
Figure 2: SkillNet 将异构用户输入和开放互联网资源转化为可执行技能,通过自动化技能创建和多维评估,组织高质量技能网络。
SkillNet 由三大核心模块组成:
4.1 Skill Creation(技能创建)
从四大异构数据源自动提取技能,完全通过 LLM 驱动,用户可自定义底层模型:
| 输入源 | 说明 | 示例 |
|---|---|---|
| 执行轨迹/对话日志 | stdout/stderr 及决策链路 | Agent 调试过程记录 |
| GitHub 代码仓库 | LLM 解析 AST + README | 开源项目 |
| 半结构化文档 | 业务 SOP 翻译为机器指令 | PDF/PPT/Word |
| 自然语言提示 | 人工下发的 Prompt | ”创建一个爬虫技能” |
# 四种创建方式
client.create(trajectory_content="User: rename .jpg\nAgent: Done.", output_dir="./skills")
client.create(github_url="https://github.com/zjunlp/DeepKE", output_dir="./skills")
client.create(office_file="./guide.pdf", output_dir="./skills")
client.create(prompt="A skill for web scraping article titles", output_dir="./skills")
4.1.1 数据驱动的多阶段策展流程
原文引用: “Deduplication jointly compares skill directory structures and MD5 hashes of skill markdown files. Filtering eliminates low-quality, incomplete, or semantically meaningless skills through rule-based validation and model-based checking.”
输入数据 → 去重 (Dedup) → 过滤 (Filter) → 分类标记 → 多维评估 → 选择性整合 → 技能包库| 阶段 | 操作 | 方法 |
|---|---|---|
| 去重 | 移除冗余技能 | 联合比较目录结构 + SKILL.md 的 MD5 哈希 |
| 过滤 | 消除低质量/不完整/语义空洞技能 | 正则规则引擎 + 轻量 LLM 语义检查器 |
| 分类标记 | 归入 10 类功能类别 + 细粒度标签 | LLM 辅助分类 |
| 评估 | 五维质量评估 | LLM 评估器 (GPT-5o-mini) |
| 整合 | 建立技能间关系 | 本体定义关系自动建立 |
数据规模:
| 指标 | 数值 |
|---|---|
| 初始聚合候选技能 | 200,000+ |
| 多阶段过滤后高质量技能 | 150,000+ |
| 精选可搜索技能 | 500+ |
4.2 Skill Evaluation(技能评估)
基于 五个维度 的多维评估框架:
| 维度 | 含义 |
|---|---|
| 🛡 Safety(安全性) | 技能是否包含有害代码、敏感数据泄露等风险 |
| 🧩 Completeness(完整性) | 技能描述和指令是否完整清晰 |
| 🚀 Executability(可执行性) | 技能能否被正确解析和执行 |
| 🛠 Maintainability(可维护性) | 技能是否易于理解、更新和迭代 |
| 💰 Cost-Awareness(成本意识) | 技能执行的资源消耗是否合理 |
每个维度分为三个等级:Good / Average / Poor。
- 自动化评估: 通过 LLM 评估器(GPT-5o-mini),由细粒度 rubric 指导
- 可执行性补充验证: 包含代码的技能在受控沙箱环境中实际执行
- 质量分布特征: Safety 和 Maintainability 保持较高 Good 比例;Executability 面临更大挑战
人工验证结果
| 指标 | 数值 |
|---|---|
| 抽样技能数 | 200 |
| 人工评审员 | 3 位 PhD 级 CS 注释者 (独立盲审) |
| 平均绝对误差 (MAE) | < 0.03 (全维度) |
| 二次加权 Kappa (QWK) | ≈ 1.000 (近乎完美一致) |
原文引用: “We randomly sampled 200 skills for human blind review by three doctoral-level computer science annotators. The human-LLM agreement achieves MAE below 0.03 and near-perfect QWK, validating the reliability and scalability of the automated evaluator.”
4.3 Skill Analysis(技能分析)
自动分析技能间的结构和功能关系,构建大规模技能图谱。
五、Skill Ontology(技能本体)
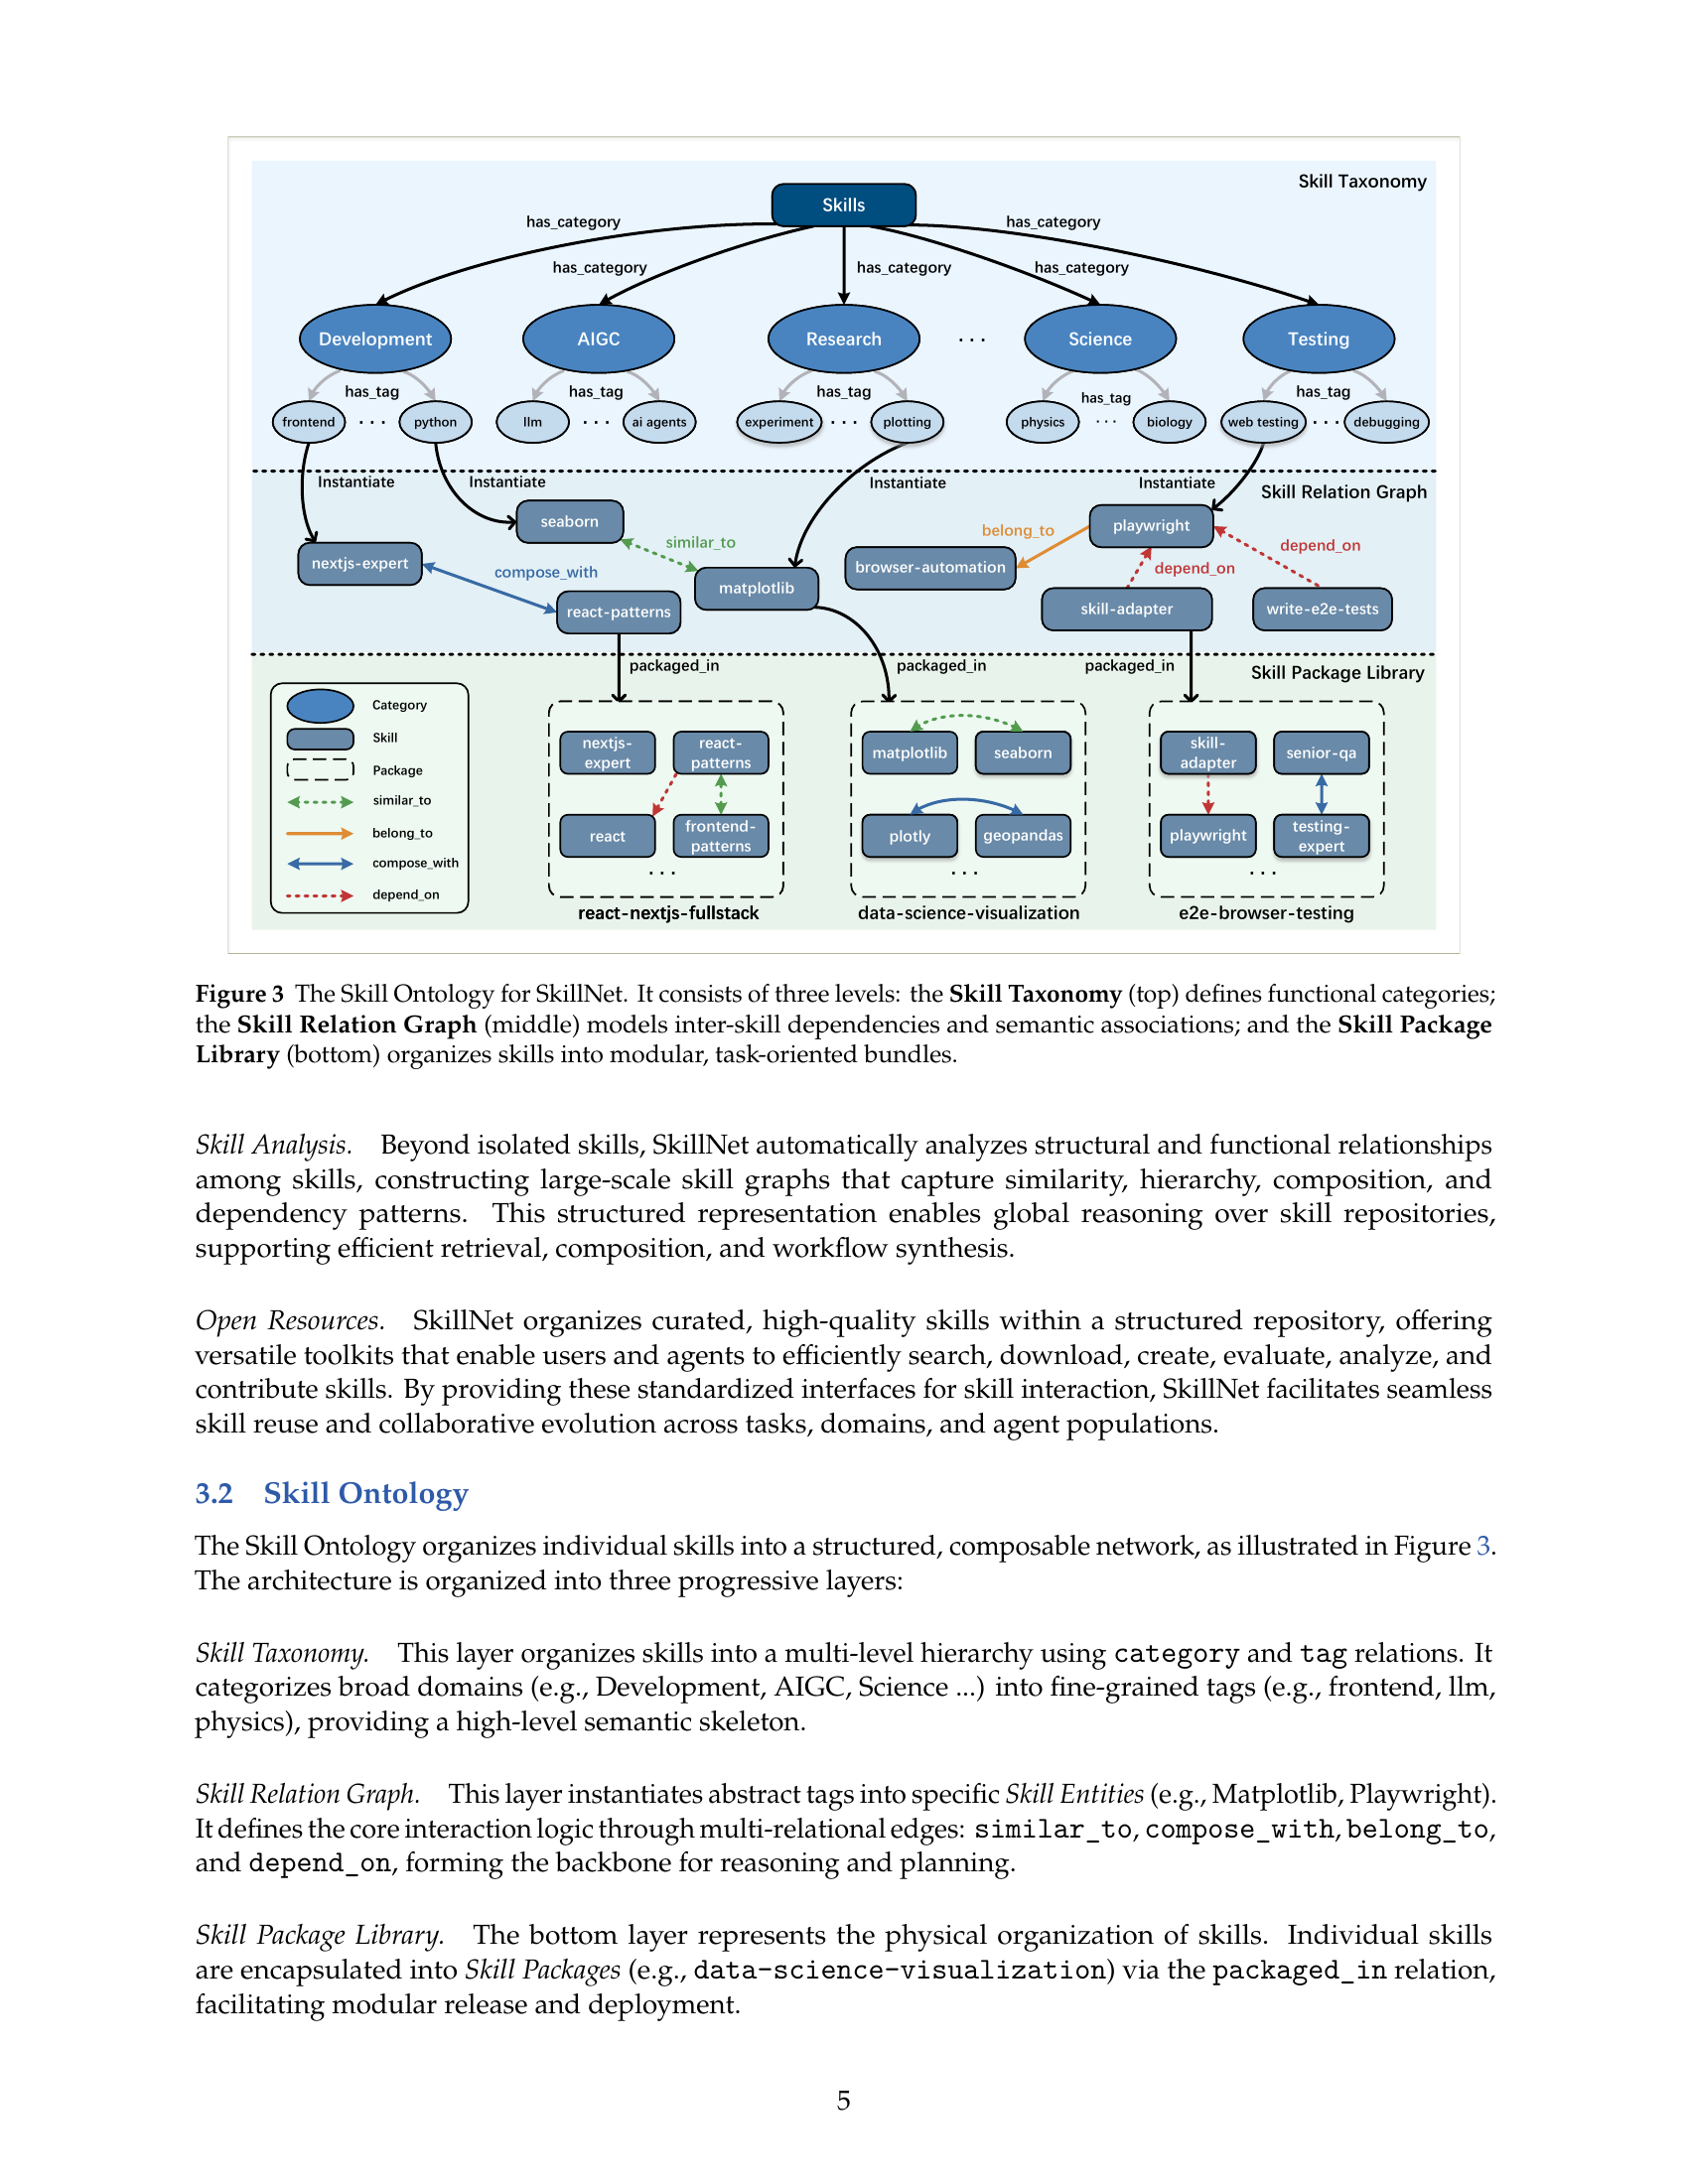
Figure 3: SkillNet 的三层本体架构:
- Skill Taxonomy(技能分类树)(顶层):通过
category和tag关系定义功能类别 - Skill Relation Graph(技能关系图)(中层):建模技能间的多种关系
- Skill Package Library(技能包库)(底层):将技能封装为模块化、面向任务的可部署包
技能间的关键关系类型
| 关系 | 含义 | 应用场景 |
|---|---|---|
similar_to | 功能等价或高度相似,可互换 | 冗余检测、容错替换、鲁棒性增强 |
belong_to | 技能是某个复合工作流的子组件 | 技能抽象、模块化拆解 |
compose_with | 常被协同调用,输出互为输入 | 自动工作流组合、管道生成 |
depend_on | 依赖前置技能(环境配置、API 初始化) | DAG 执行规划、并发拦截 |
自动化关系图构建方法
原文引用: “The construction of the Skill Relation Graph relies on a hybrid pipeline integrating semantic embedding, dependency extraction, execution trace alignment, and LLM reasoning for structured relationship inference.”
语义嵌入相似性匹配 ──┐
依赖信息提取 ────────┤
执行轨迹对齐 ────────┤──→ 候选关系集 → LLM 结构化推理 → 技能关系图
共现模式分析 ────────┘最终形成有向、类型化的多关系图——节点为技能实体,边为四种类型的有向关系。
六、开放资源与工具
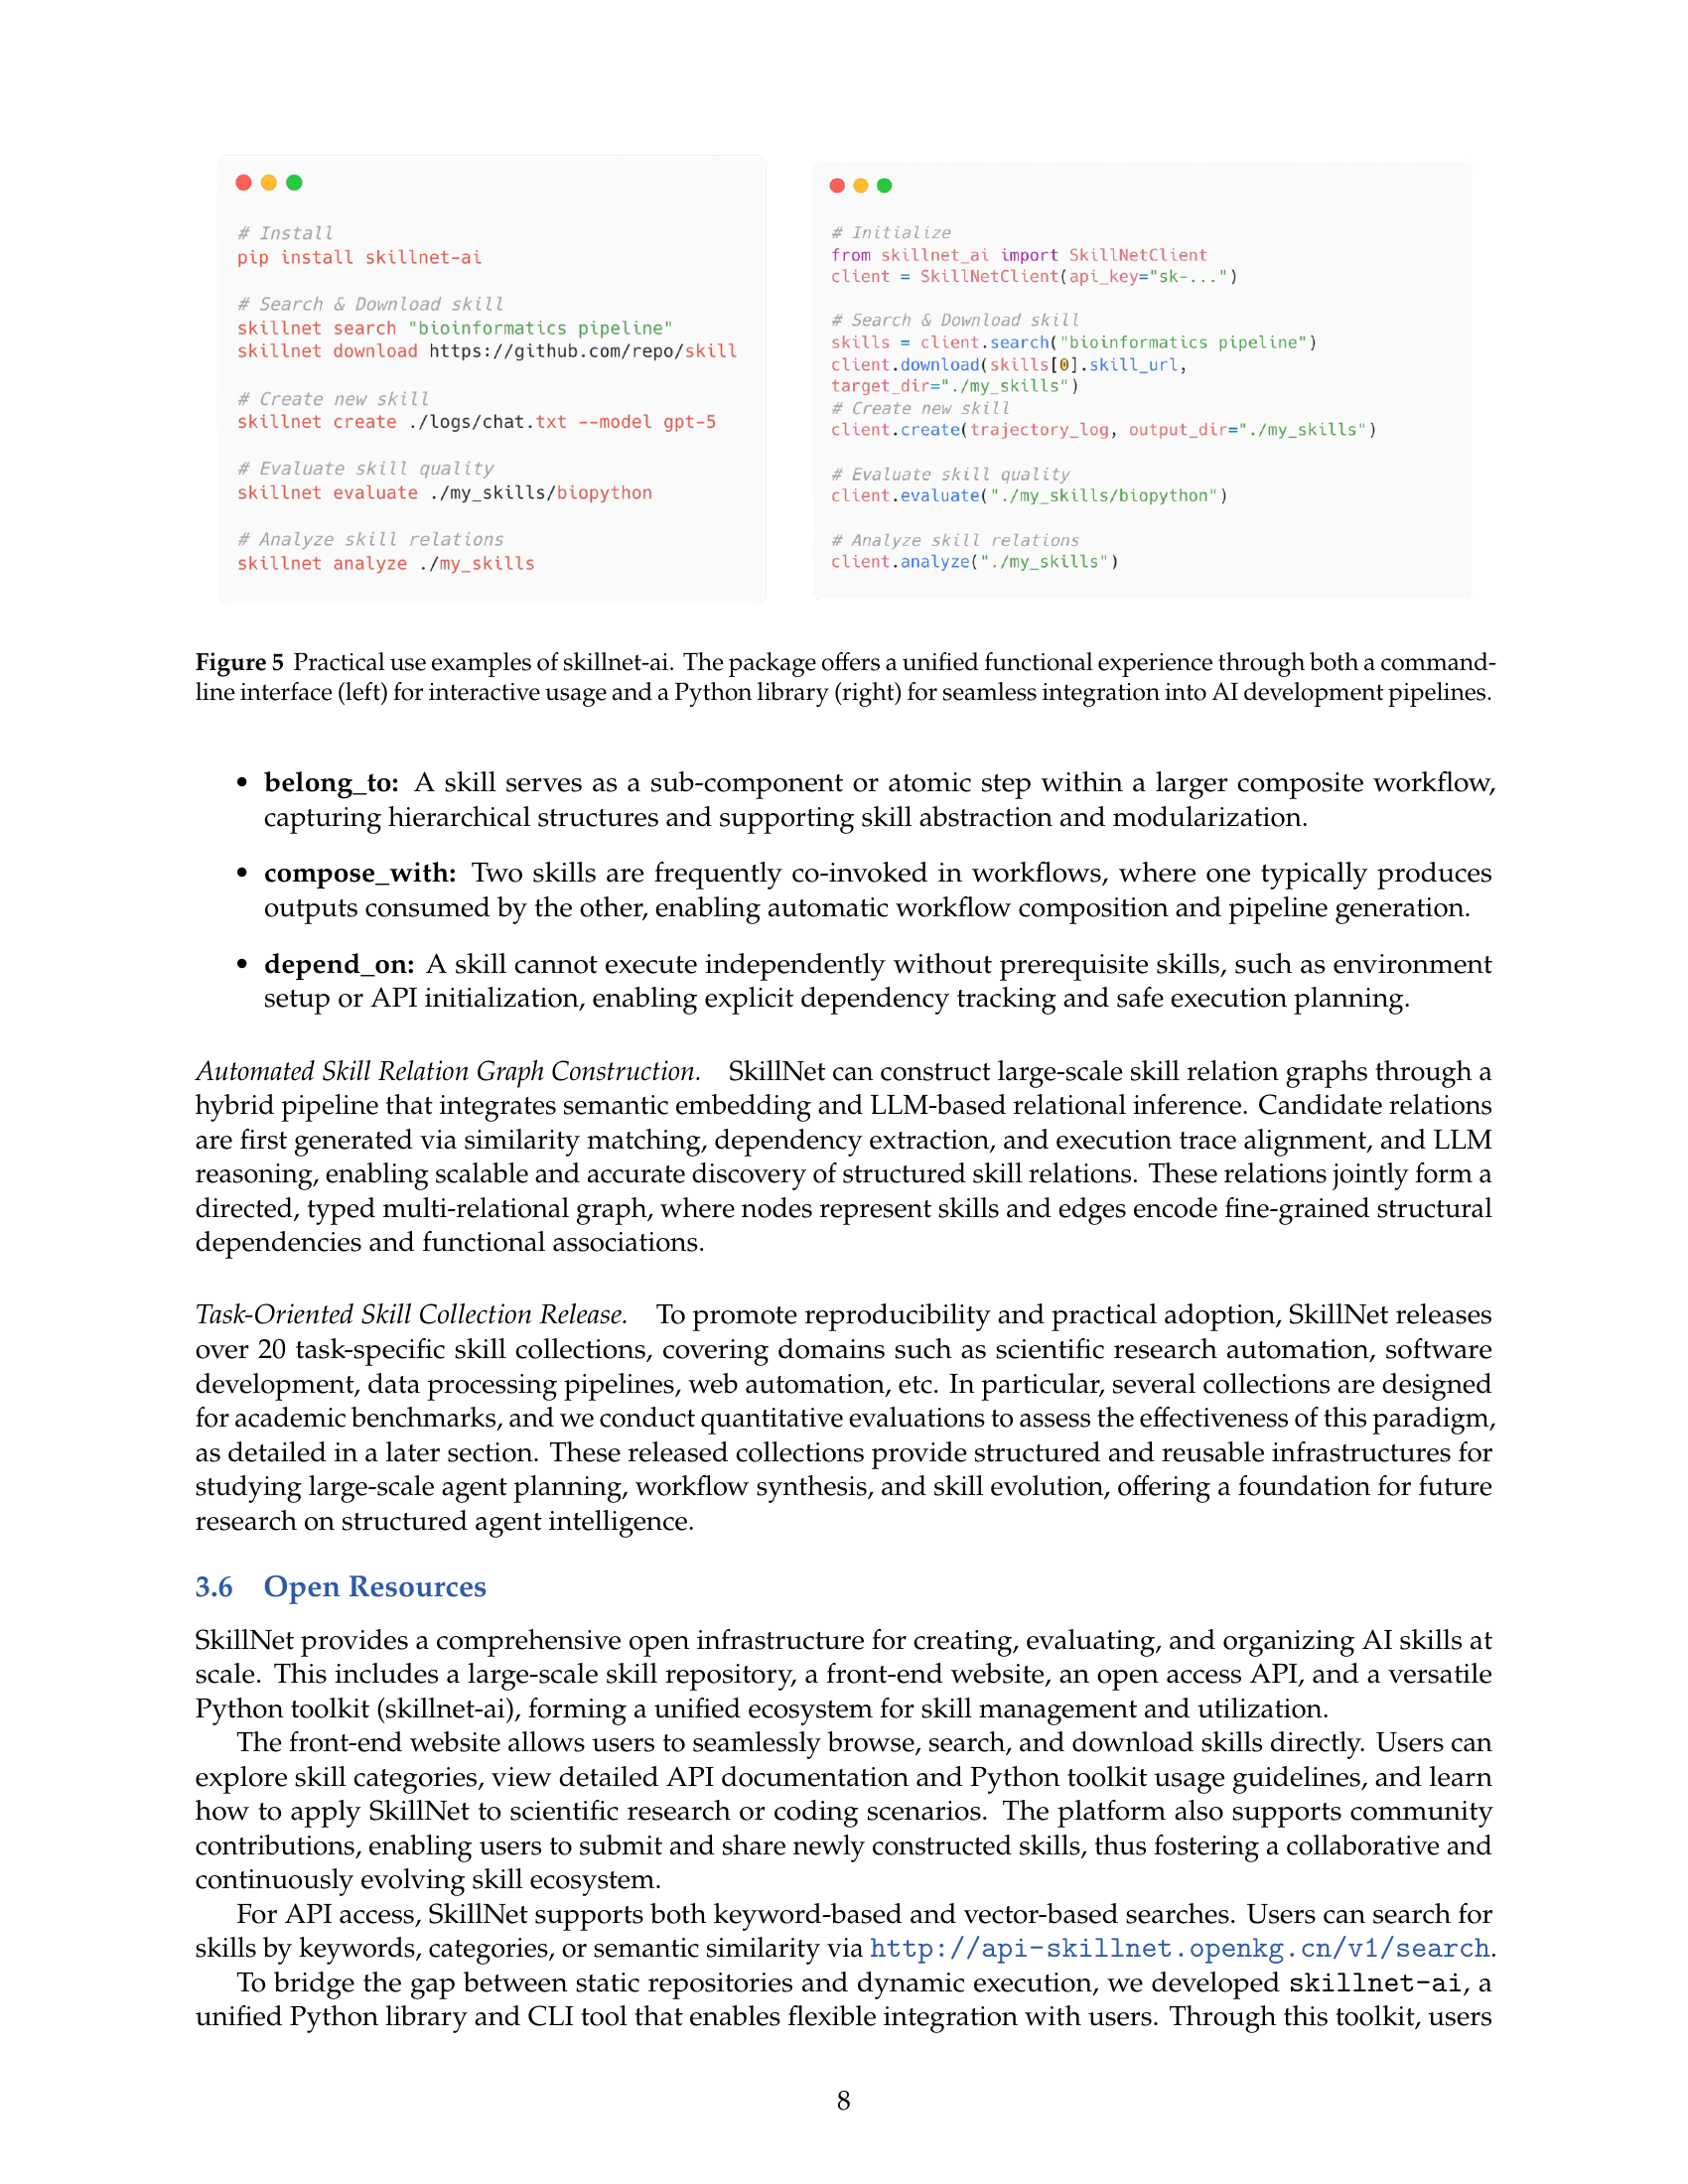
Figure 5: SkillNet 提供命令行界面(左)和 Python 库(右)的统一功能体验。
SkillNet 提供完整的开放基础设施:
- 大规模技能仓库: 150,000+ 经过筛选的高质量技能
- 前端网站: 浏览、搜索、下载技能
- 开放 API: 支持关键词和向量化搜索
- Python 工具包 (
skillnet-ai): 统一的 CLI 和编程接口
# 安装
pip install skillnet-ai

# 搜索技能
skillnet search "bioinformatics pipeline"

# 下载技能
skillnet download https://github.com/repo/skill

# 从轨迹创建技能
skillnet create ./logs/chat.txt --model gpt-5

# 评估技能质量
skillnet evaluate ./my_skills/biopython

# 分析技能关系
skillnet analyze ./my_skills
七、实验评估
7.1 实验设置
在三个文本模拟环境中评估:
- ALFWorld: 家庭环境中的导航与物体操作
- WebShop: 模拟真实电商购物场景
- ScienceWorld: 虚拟科学实验室
基线方法: ReAct, Expel, Few-Shot
骨干模型: DeepSeek V3.2, Gemini 2.5 Pro, o4 Mini
7.2 核心结果
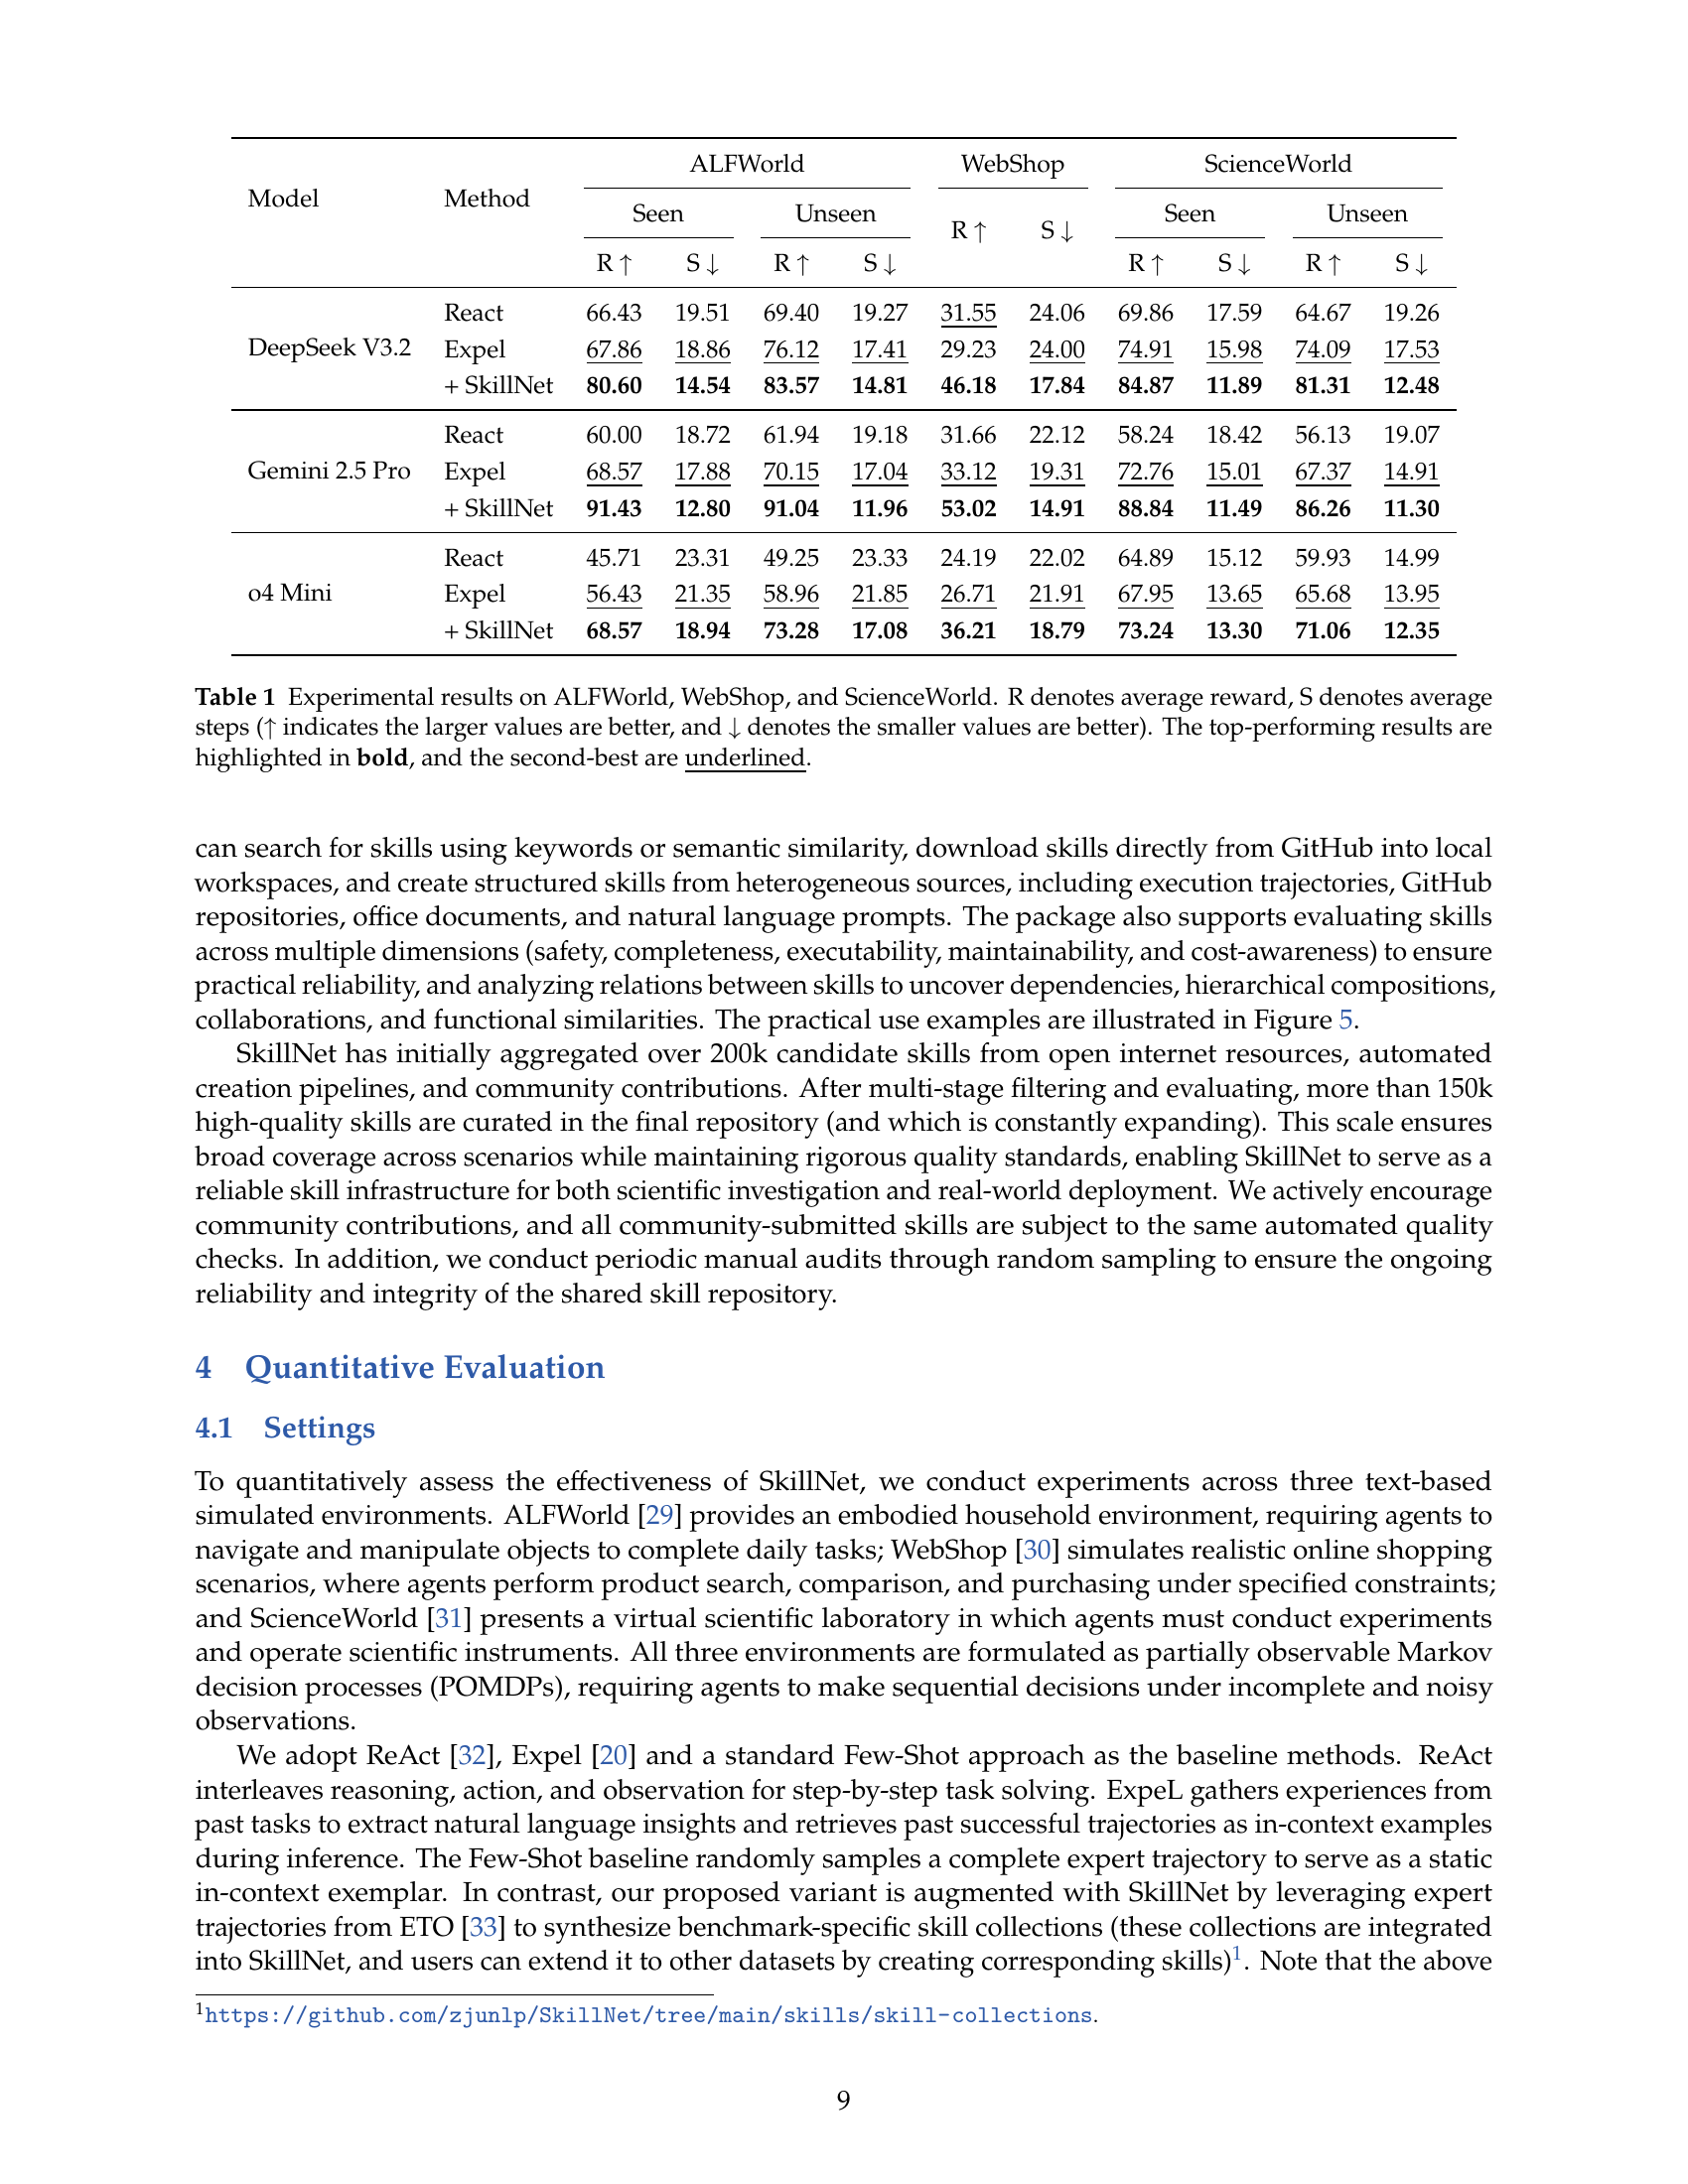
Table 1: 三个环境下的实验结果,R↑ 为平均奖励(越高越好),S↓ 为平均步数(越低越好)。
完整数据表格
| 模型 | 方法 | ALFWorld R↑ | ALFWorld S↓ | WebShop R↑ | WebShop S↓ | ScienceWorld R↑ | ScienceWorld S↓ |
|---|---|---|---|---|---|---|---|
| DeepSeek V3.2 | ReAct | 66.43 | 19.51 | 69.40 | 19.27 | 31.55 | 24.06 |
| ExpeL | 67.86 | 18.86 | 76.12 | 17.41 | 29.23 | 24.00 | |
| +SkillNet | 80.60 | 14.54 | 83.57 | 14.81 | 81.31 | 12.48 | |
| Gemini 2.5 Pro | ReAct | 60.00 | 18.72 | 61.94 | 19.18 | 31.66 | 22.12 |
| ExpeL | 68.57 | 17.88 | 70.15 | 17.04 | 33.12 | 19.31 | |
| +SkillNet | 91.43 | 12.80 | 91.04 | 11.96 | 86.26 | 11.30 | |
| o4 Mini | ReAct | 45.71 | 23.31 | 49.25 | 23.33 | 24.19 | 22.02 |
| ExpeL | 56.43 | 21.35 | 58.96 | 21.85 | 26.71 | 21.91 | |
| +SkillNet | 68.57 | 18.94 | 73.28 | 17.08 | 71.06 | 12.35 |
关键发现:
Compared with ReAct, SkillNet improves the average reward by 40%, while reducing the number of interaction steps by 30% on average, indicating that agents equipped with SkillNet are able to solve tasks more reliably while executing shorter and more coherent action trajectories.
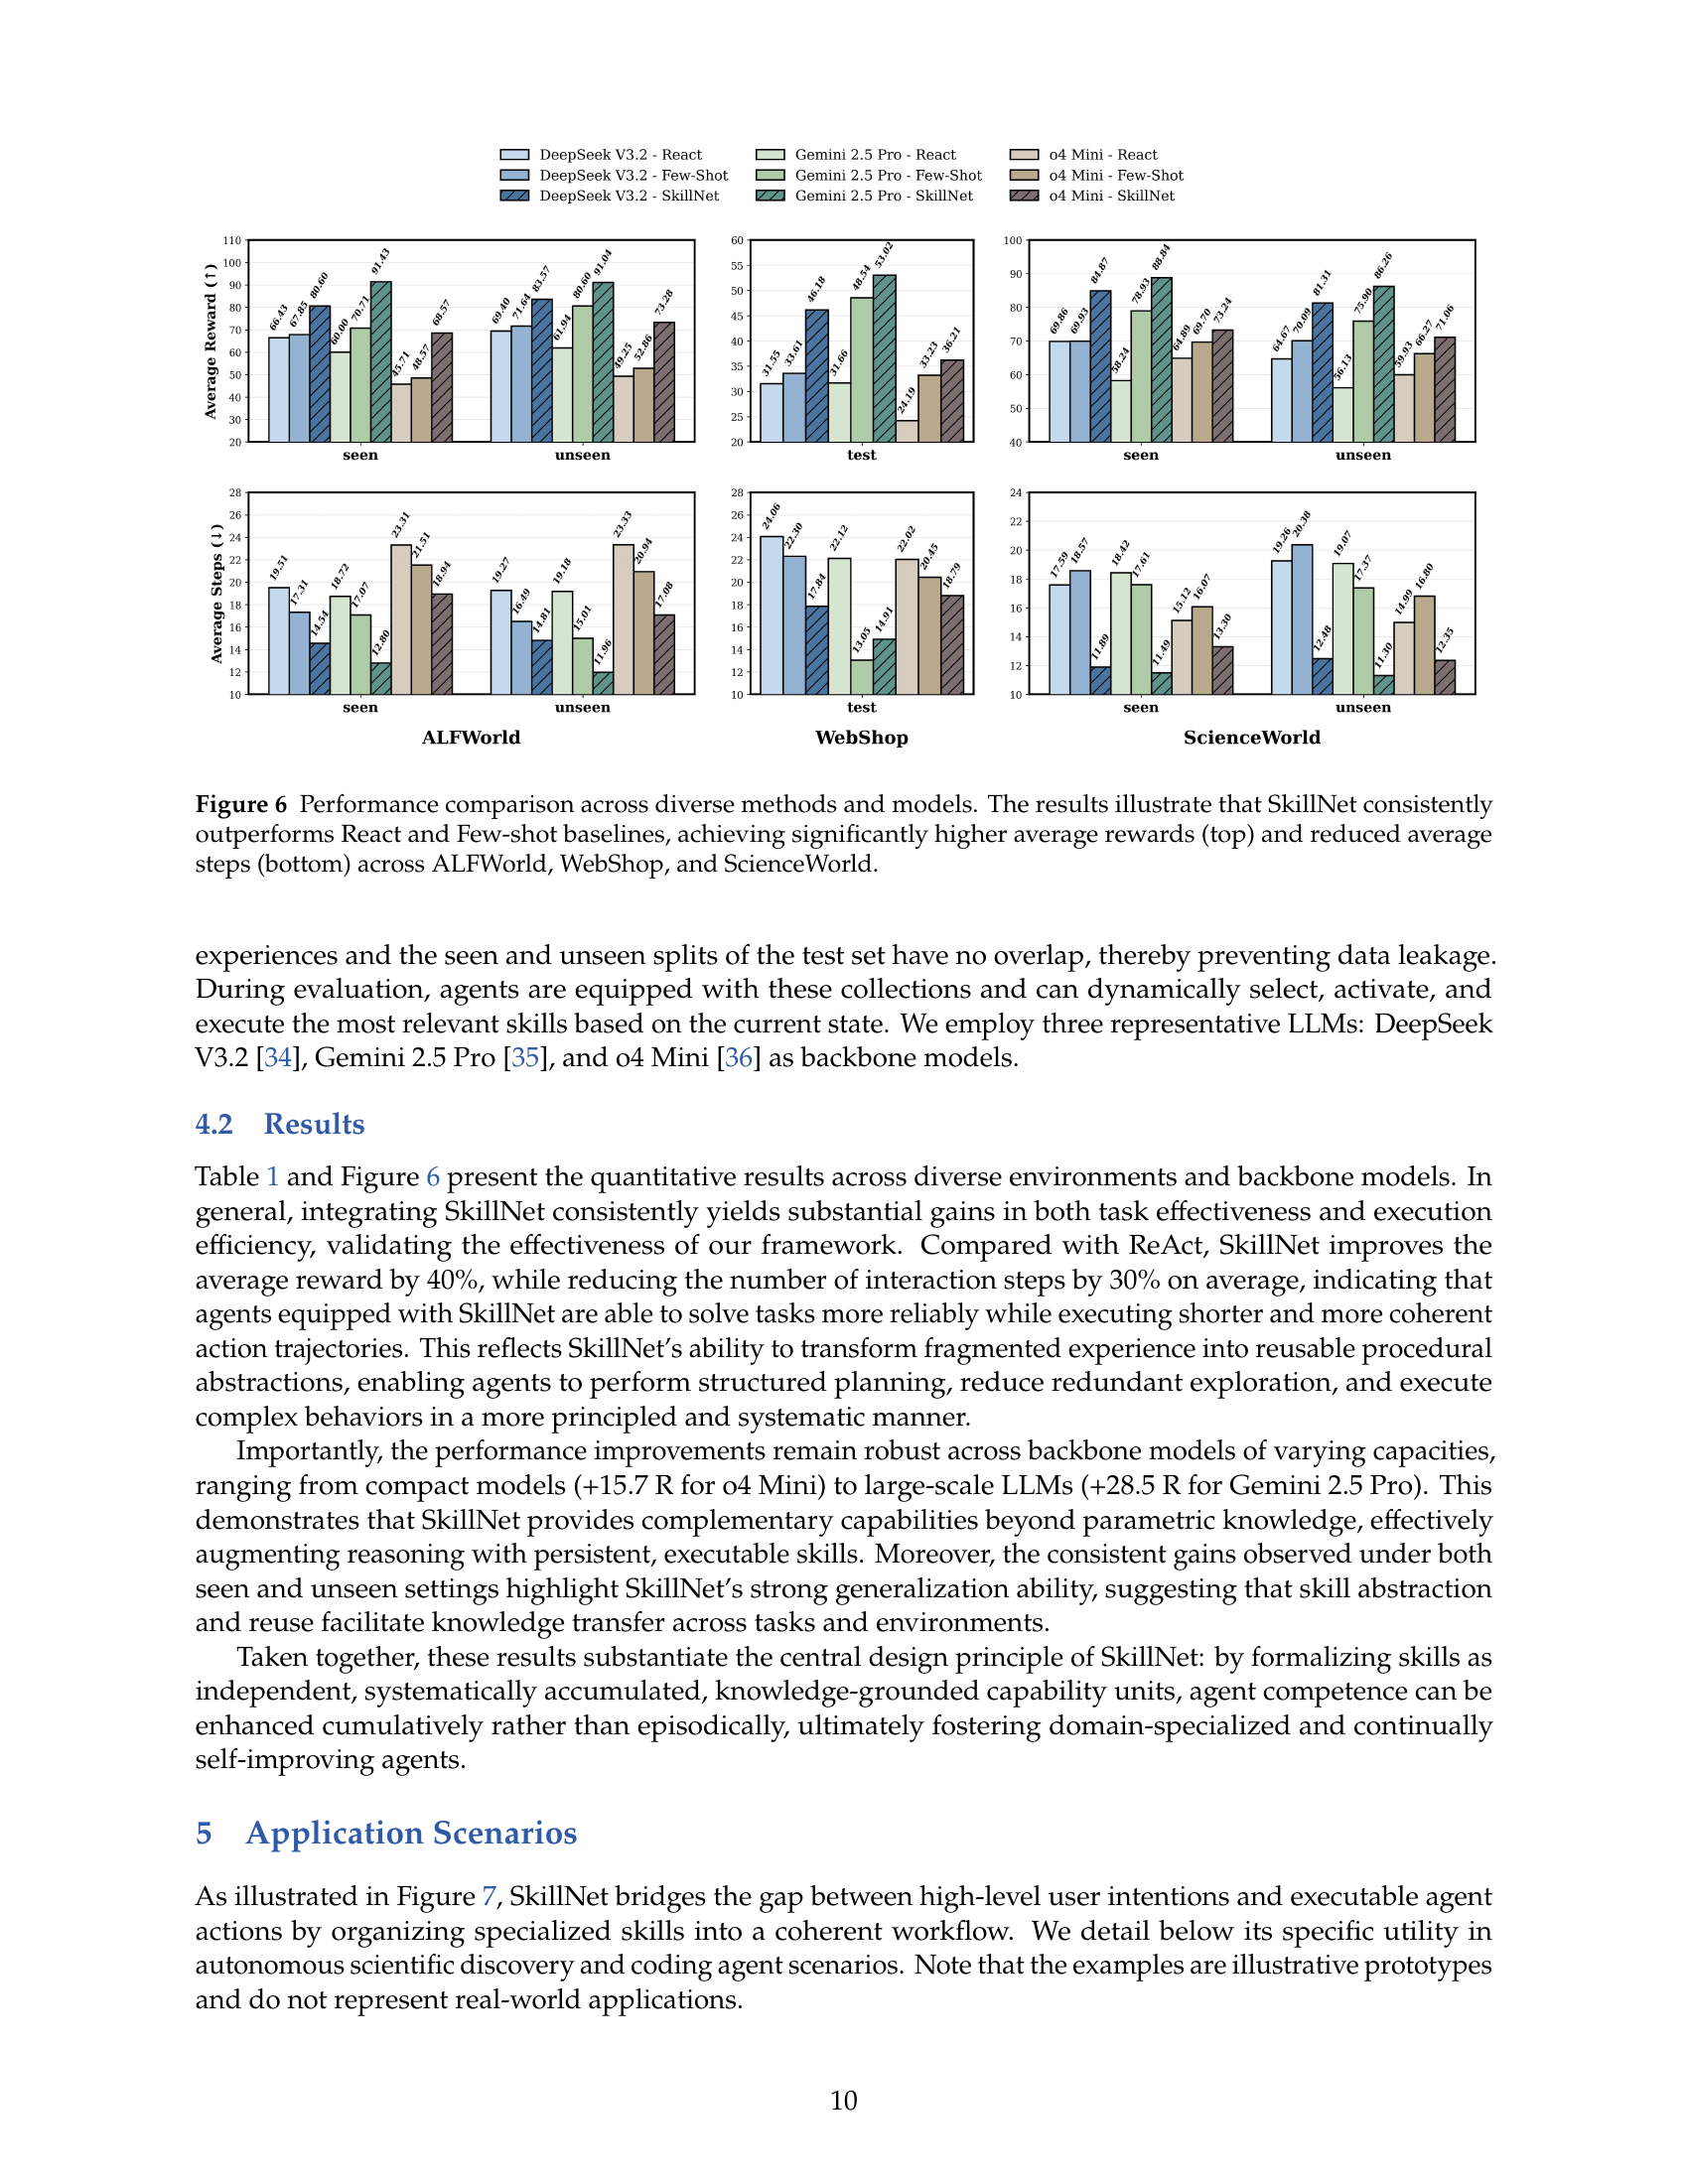
Figure 6: 跨不同方法和模型的性能对比。SkillNet 一致性地取得更高平均奖励(上)和更少平均步数(下)。
性能提升要点:
- 性能提升在不同规模模型上一致稳健: 从紧凑模型 o4 Mini(+15.7 R)到大规模模型 Gemini 2.5 Pro(+28.5 R)
- 在 seen 和 unseen 设置下均取得一致提升,说明技能抽象和复用具有强泛化能力
- SkillNet 为模型提供了超越参数化知识的互补能力
特别值得注意: ScienceWorld 环境中提升极其显著——o4 Mini 从 24.19 跃升至 71.06 (+46.87),Gemini 2.5 Pro 从 31.66 跃升至 86.26 (+54.60)。这说明结构化技能知识在复杂科学推理任务中的价值最为突出。
八、应用场景
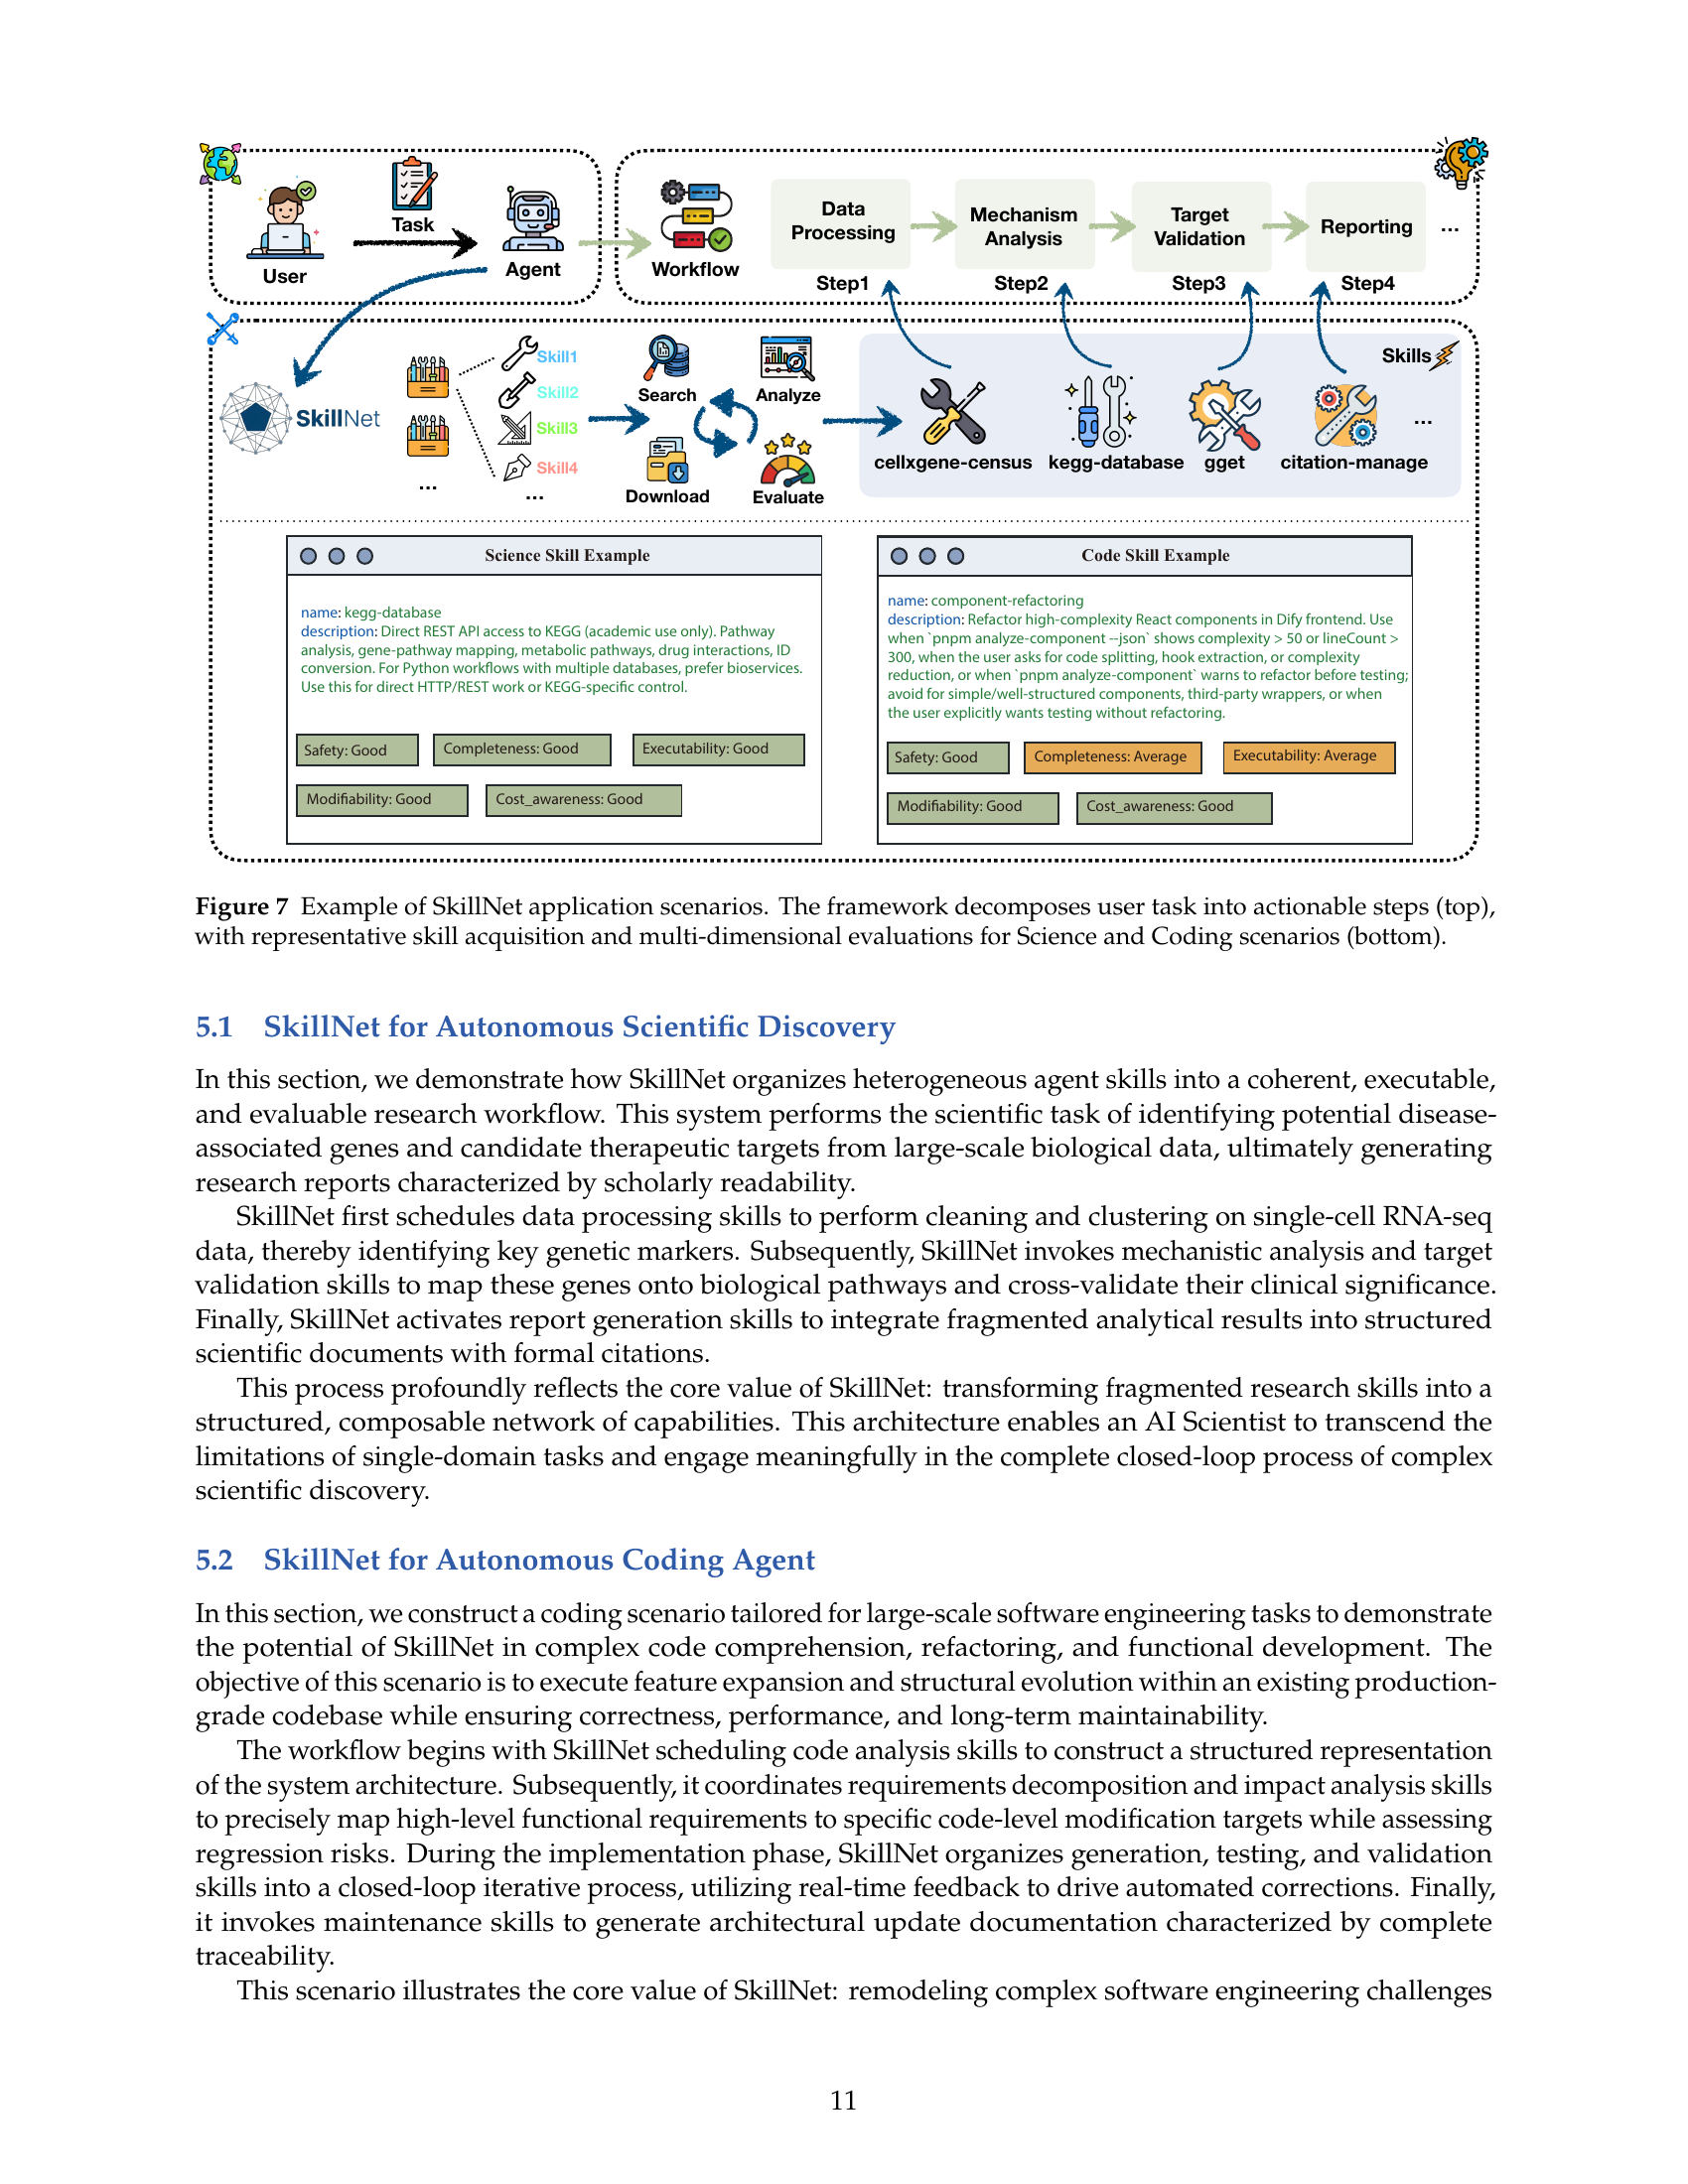
Figure 7: SkillNet 应用场景示例 — 将用户任务分解为可执行步骤,并展示代表性技能的多维评估。
8.1 自主科学发现 (Autonomous Scientific Discovery)
SkillNet 将异构 Agent 技能组织为连贯的研究工作流:
- 数据处理技能 → 清洗和聚类单细胞 RNA-seq 数据
- 机制分析技能 → 将基因映射到生物通路
- 靶标验证技能 → 交叉验证临床意义
- 报告生成技能 → 整合为结构化科研文档
8.2 自主编码 Agent (Autonomous Coding Agent)
面向大规模软件工程任务:
- 代码分析技能 → 构建系统架构表征
- 需求分解技能 → 将高层需求映射到代码修改目标
- 生成、测试、验证技能 → 闭环迭代实现
- 维护技能 → 生成完整可追溯的架构更新文档
九、与现有平台的对比
原文引用 (论文 Table 2): 以下是 SkillNet 与当前主要 AI Agent 技能平台的系统性对比。
| 维度 | SkillNet(本文) | ClawHub | SkillsMP | SkillHub | Skills.sh |
|---|---|---|---|---|---|
| 核心定位 | 完整生命周期基础设施 | npm 类版本管理 | 大规模开源目录 | 高级策展市场 | 通用技能目录 |
| 自动创建 | ✅ 四种输入源 (LLM) | ❌ | ❌ | ❌ | ❌ |
| 质量评估 | ✅ 五维度体系 | ❌ (仅推荐) | 基础过滤 (stars) | 内置 LLM 评级 | 社区排行榜 |
| 关系分析 | ✅ 技能图谱 | ❌ | ❌ | 手动预配置 | ❌ |
| 集成分发 | Python SDK & CLI | npx 包管理器 | GitHub 聚合 & CLI | 桌面客户端 | 通用 CLI |
| 搜索机制 | 向量语义 + 关键词 | 向量语义 + 版本控制 | AI 语义 + 关键词 | 语义 + 排名 | 全局目录 |
| 技能数量 | 250k+ 总 / 150k+ 策展 | ~9k+ | ~261k+ | ~21k+ | ~71k+ |
SkillNet 的三大独特优势:
- 唯一支持自动创建: 从轨迹、代码、文档自动生成技能,其他平台均不支持
- 最全面的评估框架: 五维评估 + 人工验证(MAE < 0.03),远超其他平台的简单过滤
- 唯一支持关系建模: 自动构建技能间 similar_to / belong_to / compose_with / depend_on 关系图谱
十、Related Work 核心对比
10.1 经验整合与技能抽象
论文系统性地分析了现有 Agent 经验积累方法的不足:
原文引用: “Despite these advances, most methods still represent skills implicitly—encoded in prompts, latent memories, or loosely organized workflows—thereby hindering systematic consolidation, evaluation, and reuse.”
| 方法 | 特点 | 局限 |
|---|---|---|
| Reflexion | 从失败中总结纠正反馈 | 技能隐式编码在 prompt 中,无法跨会话复用 |
| ExpeL | 从过去任务中提取自然语言 insight | 缺乏结构化组织和质量评估 |
| Voyager (Minecraft) | 自动发现和积累技能 | 领域特定,无法泛化到开放世界 |
| Memory-centric 方法 | 积累长期经验支持持续学习 | 记忆缺乏操作边界,难以模块化 |
| SkillsBench | 86 任务 × 11 域基准 | 显示策展技能可提升 +16.2 pp,但自生成技能无收益 |
SkillNet 的差异化: 将技能从隐式表示提升为显式、结构化、可评估、可组合的一等公民。
10.2 现有技能库的三个关键缺陷
原文引用: “Existing platforms suffer from three key limitations: (1) lack of automated mechanisms for dynamically generating skills from agent trajectories or existing codebases; (2) evaluation practices mainly focus on simple community metrics without providing comprehensive insight into intrinsic attributes; (3) skill collections often suffer from redundancy, fragility, and poor composability because skills are treated as isolated entities.”
SkillNet 针对性地解决了这三个问题:去重+过滤(对应缺陷1)、五维评估(对应缺陷2)、关系图谱(对应缺陷3)。
十一、未来方向
论文提出三个关键未来方向:
11.1 开放世界技能演进 (Open-World Skill Evolution)
原文引用: “Achieving automatic skill discovery, abstraction, and cross-domain transfer in open-world settings remains highly challenging. Industry-specific, privately curated SkillNets may themselves become foundational components of agent infrastructure.”
在工业制造、金融和科学研究等领域,需要复杂任务的动态组合和优化。将技能演进机制与在线反馈、因果推理和不确定性建模相集成,有望提高技能选择的可靠性。
11.2 模型-技能协同 (Model-Skill Synergy)
原文引用: “How to leverage neuro-symbolic integration and memory mechanisms so that skill structures guide model decision paths, and how to dynamically restructure skill hierarchies and dependencies as model capabilities evolve.”
当前技能仅作”外部挂载磁盘”使用。将技能拓扑图参数通过反向传播写入神经网络(Neuro-Symbolic 融合)是下一代系统需要跨越的鸿沟。
11.3 多 Agent 协作与知识共享
原文引用: “SkillNet can further support the emergence of digital avatars whose capabilities are progressively distilled from accumulated skills. More broadly, this paradigm may open pathways to collective intelligence.”
在多 Agent 环境中作为共享表示和交换层,支持协作规划、知识迁移和跨 Agent 经验积累。
十二、局限性
- 技能覆盖不完整: 私有领域和高度隐性知识难以捕获
- 自构建技能质量无法完全保证: 虽有评估过滤,但部分技能仍缺乏严格系统性评估;对”投毒”技能的防护仍有限
- 端到端流水线尚未建立: 从自然语言需求到完全实例化 Agent 的端到端管道仍是未来工作
十三、核心总结
SkillNet 是首个大规模、系统化的 AI Agent 技能基础设施,其核心创新在于:
- 统一框架: 将碎片化的 Agent 经验转化为结构化、可组合的模块化技能网络
- 严格评估: 建立五维评估体系(安全性、完整性、可执行性、可维护性、成本意识)
- 显著效果: 在三个基准上平均奖励提升 40%,交互步数减少 30%
- 开放生态: 200,000+ 技能仓库、交互式平台、Python 工具包全面开源
概念框架: SkillNet 基于对 Agent 能力的三个互补约束的统一视角:
原文引用: “Workflows impose explicit procedural structure, ensuring reliability but inherently remaining rigid. Memory accumulates contextual experience and associated knowledge, enabling adaptation but lacking operational boundaries. Skills bridge both extremes by packaging reusable ability units that constrain generation and organize memory into actionable patterns.”
| 约束类型 | 特点 | 局限 |
|---|---|---|
| Workflow | 显式程序结构,确保可靠性 | 刚性,难以适应变化 |
| Memory | 积累上下文经验 | 缺乏操作边界 |
| Skill (SkillNet) | 桥接两者:打包可复用能力单元 | 实现结构化 + 灵活性统一 |
远景愿景: “一人公司”或”一人实验室”——个人策划技能仓库,Agent 将其组合成工作流,记忆通过经验持续改进。
原文引用: “Through SkillNet, skills become the primary unit of knowledge consolidation and delegation: individuals curate skill repositories, agents compose them into workflows, and memories refine them through experience. This closed loop transforms isolated automation into cumulative machine expertise.”
By formalizing skills as evolving, composable assets, SkillNet provides a robust foundation for agents to move from transient experience to durable mastery.
十四、结合 SkillNet 做 LLM 数据合成研究的思路方向
基于对 SkillNet 的全面研究,以下从多个维度提出将其与 LLM 数据合成研究结合的系统化思路。
思路一:技能图谱作为数据合成的结构化骨架 (Scaffold)
核心想法: 利用 SkillNet 的三层本体架构和四种关系边,作为数据合成的骨架来指导训练数据生成,解决数据”主题分布不均”的根本问题。
具体路径:
- 技能分解驱动的数据拆分: 利用
belong_to关系将复杂任务拆解为原子技能,为每个原子技能生成对应训练样本,再通过compose_with关系生成组合任务的多步骤训练数据 - 关系感知的数据增强: 利用
similar_to关系,对同一功能生成多种实现路径的训练样本(如 “用 pandas 分析” vs “用 polars 分析”),提升模型对功能等价但实现不同的方案的泛化能力 - 依赖链驱动的长链推理数据: 利用
depend_on的 DAG 结构,生成需要多步前置条件判断的复杂推理链训练数据
示例: 利用 belong_to + compose_with 关系生成 multi-step 训练数据
[科学数据分析]
  ├── belong_to → [数据清洗] + [统计分析] + [可视化]
  └── compose_with → 数据清洗.output → 统计分析.input → 可视化.input
→ 生成: "请帮我分析这个CSV并绘图" 的完整多步训练样本预期价值: 相比随机生成,基于技能图谱的结构化生成确保数据的完整性(覆盖所有必要技能)和一致性(技能间关系合理)。
思路二:Skill-Conditioned Data Synthesis — 技能条件化数据合成
核心想法: 将 SkillNet 的 SKILL.md 格式作为条件信号 (Conditioning Signal),指导 LLM 生成特定技能维度的高质量训练数据。
方法:
Step 1: 从 SkillNet 的 200k+ 技能库按类别分层采样
Step 2: 提取每个技能的 Metadata + Usage Conditions + Instructions
Step 3: 作为 Prompt 条件前缀,让 LLM 在技能约束下生成 (query, response) 对
Step 4: 用 SkillNet 的五维评估体系作为合成数据的质量过滤器示例:
[技能条件] "数据可视化技能: 使用 matplotlib 创建多子图布局, 适用于多维数据对比场景..."
→ LLM 生成: Query="如何对比三个城市的月度温度趋势?"
            + Response=完整 matplotlib 代码 + 解释
→ 五维评估: Safety ✅ Completeness ✅ Executability ✅ → 入选训练集核心优势: 通过 SkillNet 的 10 大分类 × N 个标签 的分类法,确保每个能力维度都有充分的训练覆盖,解决数据偏斜问题。
思路三:执行轨迹的自动蒸馏-放大飞轮
核心想法: 利用 SkillNet 的 create 功能(从执行轨迹自动创建技能),构建”执行-蒸馏-放大”的数据飞轮。
循环飞轮:
Step 1: 收集高质量 Agent 执行轨迹 (如 SWE-bench 成功案例)
Step 2: 使用 skillnet create 自动提取为结构化技能
Step 3: 基于提取的技能结构,LLM 合成大量变体训练数据
Step 4: 用合成数据微调 LLM → 更强的 Agent
Step 5: 更强 Agent 产生更高质量的执行轨迹 → 回到 Step 1关键创新点:
- SkillNet 的技能提取 = 自动化”经验蒸馏器”,将稀有的成功轨迹转化为可复用的知识结构
- 基于知识结构可低成本合成大量同分布但不同实例的训练数据
- 正反馈循环,类似 Self-Play 但作用于数据层面
与 SkillNet 论文的关联: 论文实验已验证 SkillNet 利用 ETO (Expert Trajectory Optimization) 的专家轨迹合成技能集合的有效性。此思路将该方法论扩展到训练数据维度。
思路四:五维评估框架迁移到合成数据质量控制
核心想法: 将 SkillNet 的五维评估体系直接迁移到 LLM 合成训练数据的质量评估中。
| SkillNet 维度 | 合成数据质量维度 | 评估内容 |
|---|---|---|
| Safety | 安全性 | 合成数据是否包含有害内容或危险操作指令 |
| Completeness | 完备性 | 合成的 (问题, 回答) 对是否覆盖完整推理链条 |
| Executability | 可执行性 | 合成代码类数据是否能实际运行产出正确结果 |
| Maintainability | 一致性 | 合成数据是否与已有训练集在风格和格式上一致 |
| Cost-awareness | 效率性 | 合成数据中的方案是否是计算效率最优的路径 |
实施方案:
- 论文已验证 LLM 评估器与人工评审的 MAE < 0.03、QWK ≈ 1.000
- 可直接用 SkillNet 的评估 API 对合成数据自动打分
- 仅保留五维均达标的高质量数据
预期优势: 告别粗暴的”全量合成 → 随机过滤”模式,实现原则性的、多维度的合成数据质量控制。
思路五:技能覆盖度引导的 Curriculum Learning
核心想法: 利用 SkillNet 的技能分类法和关系图构建课程式学习 (Curriculum Learning) 的数据排序策略。
设计:
- 技能难度建模: 用
depend_on深度 +compose_with扇出度量化技能难度- 深度 0 = 原子技能(如 “读取文件”)→ 最简单
- 深度 3 + 扇出 5 = 复合工作流(如 “端到端数据分析管线”)→ 最难
- 训练数据标注: 为每条训练样本标注涉及的技能 ID 和难度等级
- 课程编排: 简单原子技能 → 两两组合 → 复杂多技能工作流
- 覆盖度监控: 实时监控模型在各技能维度的能力覆盖度,动态调整采样权重
训练阶段 1: [read_file] [write_file] [parse_json]          ← 原子技能
训练阶段 2: [read_file → parse_json] [API调用 → 数据清洗]    ← 二元组合
训练阶段 3: [完整 ETL 管线] [科研数据分析全流程]              ← 多技能工作流
思路六:Skill-Aware Reward Model — 技能感知的奖励模型
核心想法: 利用 SkillNet 的技能标注和评估数据,训练技能感知 (Skill-Aware) 的奖励模型,用于 RLHF/DPO 训练。
设计思路:
- 用 SkillNet 对模型输出进行技能级别标注(识别回答涉及哪些技能)
- 基于技能评估维度为每个回答生成细粒度的技能级奖励信号
- 奖励模型不只判断”回答好不好”,还判断”每个涉及的技能执行得好不好”
- RL 训练中获得更精细的梯度信号,加速特定技能的习得
示例: 一个回答涉及 [数据清洗, 统计分析, 可视化] 三个技能,传统 RM 给一个总分,Skill-Aware RM 给三个分项分数,使模型知道”可视化做得好但统计分析有误”。
思路七:跨领域技能迁移合成
核心想法: 利用 similar_to 关系发现跨领域的技能同构,生成跨领域迁移训练数据。
示例:
"数据分析中的异常检测" ←similar_to→ "网络安全中的入侵检测"
"生物序列比对"         ←similar_to→ "文本相似度匹配"
"供应链优化" ←similar_to→ "网络路由优化"方法: 将数据丰富领域的成功案例,通过 LLM 改写为数据稀缺领域的训练数据,利用技能的抽象结构保持核心推理模式不变,仅替换领域术语和具体细节。
预期价值: 解决垂直领域训练数据稀缺问题,低成本实现跨域知识迁移。
思路八:技能图谱驱动的 Benchmark 自动构建
核心想法: 利用 SkillNet 的分类体系和关系图谱,自动化构建 Agent 能力评测基准。
方案:
- 从技能分类法枚举所有能力维度 (10 类 × N 标签)
- 对每个技能节点自动生成测试任务
- 利用
compose_with和depend_on关系生成复合型测试用例 - 基于关系图拓扑排序确保测试用例的难度梯度
- 动态生成新测试用例以防数据泄漏和过拟合
与论文工作的衔接: 论文已发布 20+ 个任务特定技能集合(科学、开发、数据处理等),可直接作为 Benchmark 构建的种子。
思路汇总与优先级建议
| 思路 | 创新性 | 可行性 | 预期影响 | 推荐优先级 |
|---|---|---|---|---|
| 一、技能图谱骨架 | ★★★★ | ★★★★ | ★★★★★ | P0 |
| 二、技能条件化合成 | ★★★ | ★★★★★ | ★★★★ | P0 |
| 三、执行轨迹飞轮 | ★★★★★ | ★★★ | ★★★★★ | P1 |
| 四、五维评估迁移 | ★★★ | ★★★★★ | ★★★★ | P0 |
| 五、Curriculum Learning | ★★★★ | ★★★ | ★★★★ | P1 |
| 六、Skill-Aware RM | ★★★★★ | ★★ | ★★★★★ | P2 |
| 七、跨领域迁移合成 | ★★★★ | ★★★ | ★★★ | P2 |
| 八、Benchmark 自动构建 | ★★★ | ★★★★ | ★★★ | P1 |
推荐的最小可行切入点: 组合思路二(技能条件化合成)+ 思路四(五维评估迁移),可在 2-3 周内实现一个端到端的 PoC:
- 从 SkillNet API 按类别采样技能描述
- 用技能描述作为条件生成训练数据
- 用五维评估过滤低质量数据
- 在下游任务上验证训练效果
引用信息
@misc{liang2026skillnetcreateevaluateconnect,
      title={SkillNet: Create, Evaluate, and Connect AI Skills},
      author={Yuan Liang and Ruobin Zhong and Haoming Xu and Chen Jiang and Yi Zhong and
              Runnan Fang and Jia-Chen Gu and Shumin Deng and Yunzhi Yao and Mengru Wang and
              Shuofei Qiao and Xin Xu and Tongtong Wu and Kun Wang and Yang Liu and Zhen Bi and
              Jungang Lou and Yuchen Eleanor Jiang and Hangcheng Zhu and Gang Yu and
              Haiwen Hong and Longtao Huang and Hui Xue and Chenxi Wang and Yijun Wang and
              Zifei Shan and Xi Chen and Zhaopeng Tu and Feiyu Xiong and Xin Xie and
              Peng Zhang and Zhengke Gui and Lei Liang and Jun Zhou and Chiyu Wu and
              Jin Shang and Yu Gong and Junyu Lin and Changliang Xu and Hongjie Deng and
              Wen Zhang and Keyan Ding and Qiang Zhang and Fei Huang and Ningyu Zhang and
              Jeff Z. Pan and Guilin Qi and Haofen Wang and Huajun Chen},
      year={2026},
      eprint={2603.04448},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2603.04448}
}
报告生成时间: 2026-03-07
数据来源: arXiv 论文 (2603.04448)、GitHub (zjunlp/SkillNet)、OpenKG 社区、CSDN OpenKG 博客